リップシンクされた対話
口の動きに後から重ねるのではなく、口の動きに合わせてタイミング調整された音声。
KuaishouのKling 3.0は話します — 5つの言語でリップシンクされた対話、キャラクターごとに異なる声、そしてシーケンス全体を構成するストーリーボードモードを備えています。
作成を始めるには、デスクトップのブラウザでこのページを開いてください。
Kling 3.0はKuaishouの第3世代動画モデルであり、ラインアップの中で際立たせている機能は音声です。
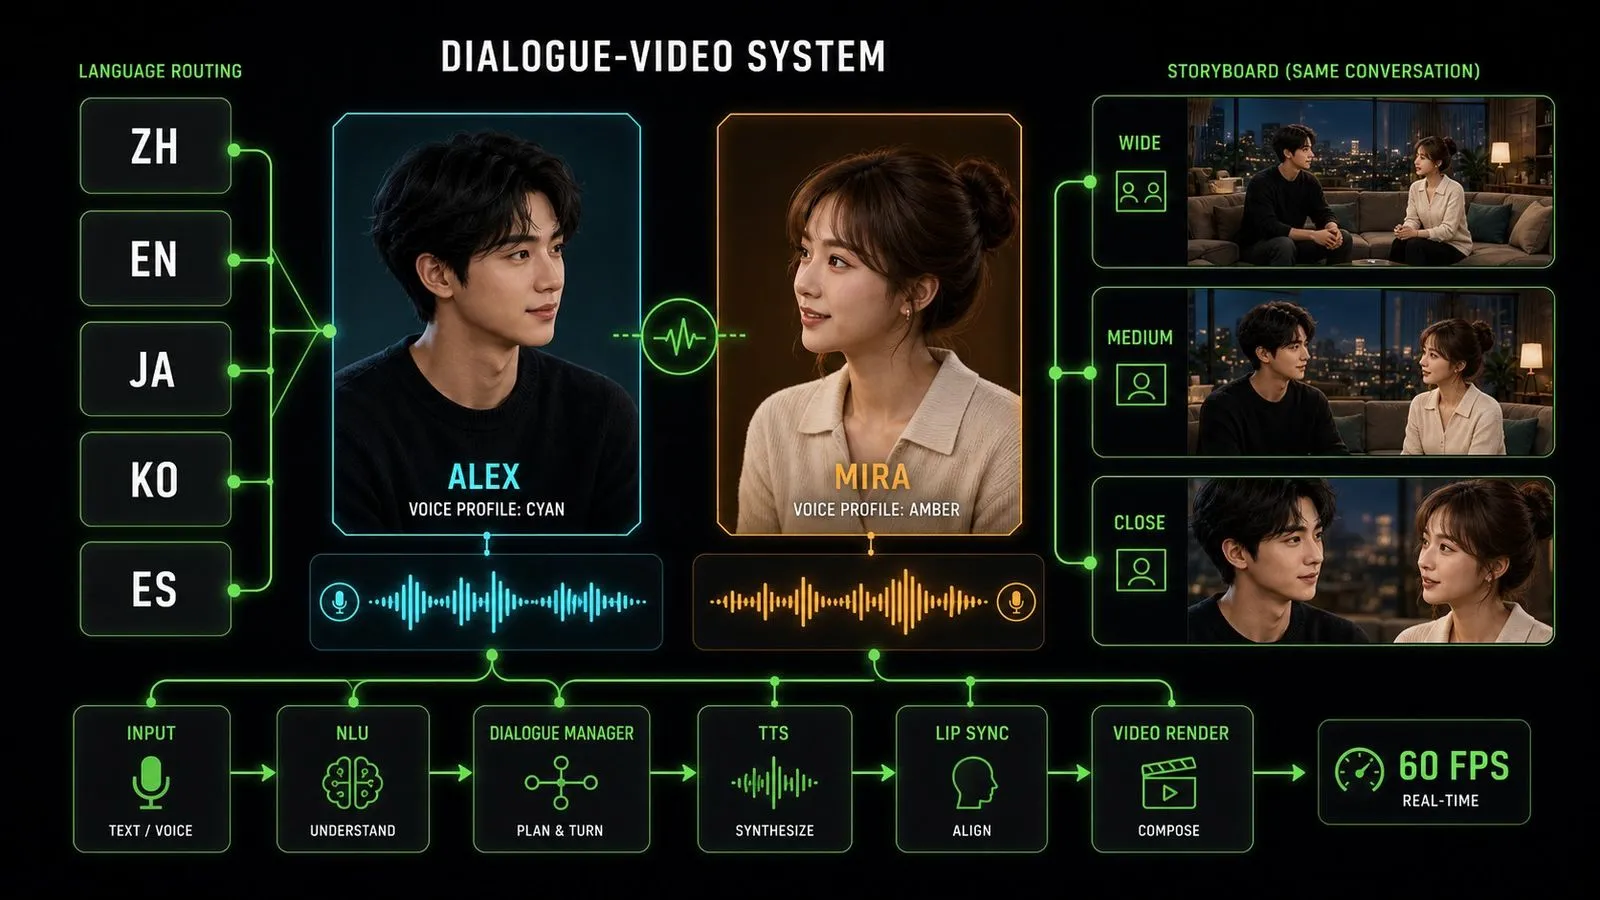
音を生成するモデルは数多くあります。しかし、リップシンクする会話を生成できるものははるかに少なく、各キャラクターに異なる声を与え、5つの言語に対応し、2人がそれぞれ別の言語で話すシーンをサポートできるものはさらに限られます。Kling 3.0は、映像と同じ生成プロセスでそれらすべてを実現し、さらに1つのプロンプトから複数の独立したカメラ設定によるシーケンスを構成するマルチショット・ストーリーボードモードも備えています。
ショット内の人物に伝えるべき台詞がある場合は、Kling 3.0を使用してください。会話シーン、物語性のある短編、プレゼンター付きの解説コンテンツ、多言語キャンペーン版、そして通常なら組み立てに複数回の生成が必要になるマルチショットシーケンスを作成できます。
Kling 3.0 は、Kuaishou が開発した AI 動画生成モデルです。開始フレーム、終了フレーム、またはその両方と、それらの間で何が起こるべきかを記述したテキストを入力します。
このモデルは、3つの大きな強みを軸に構築されています:
クリップは最大 60fps で最大15秒まで生成できます。音声は映像と同時に生成されます — 音楽、効果音、環境音、会話音声がまとめて生成されます。Virse ではこのラインを2つのエントリーとして掲載しており、Kuaishou は Standard をコスト効率の高い反復制作向け、Pro を最終品質向けと位置付けています。どちらも同一の入力を受け付けます。
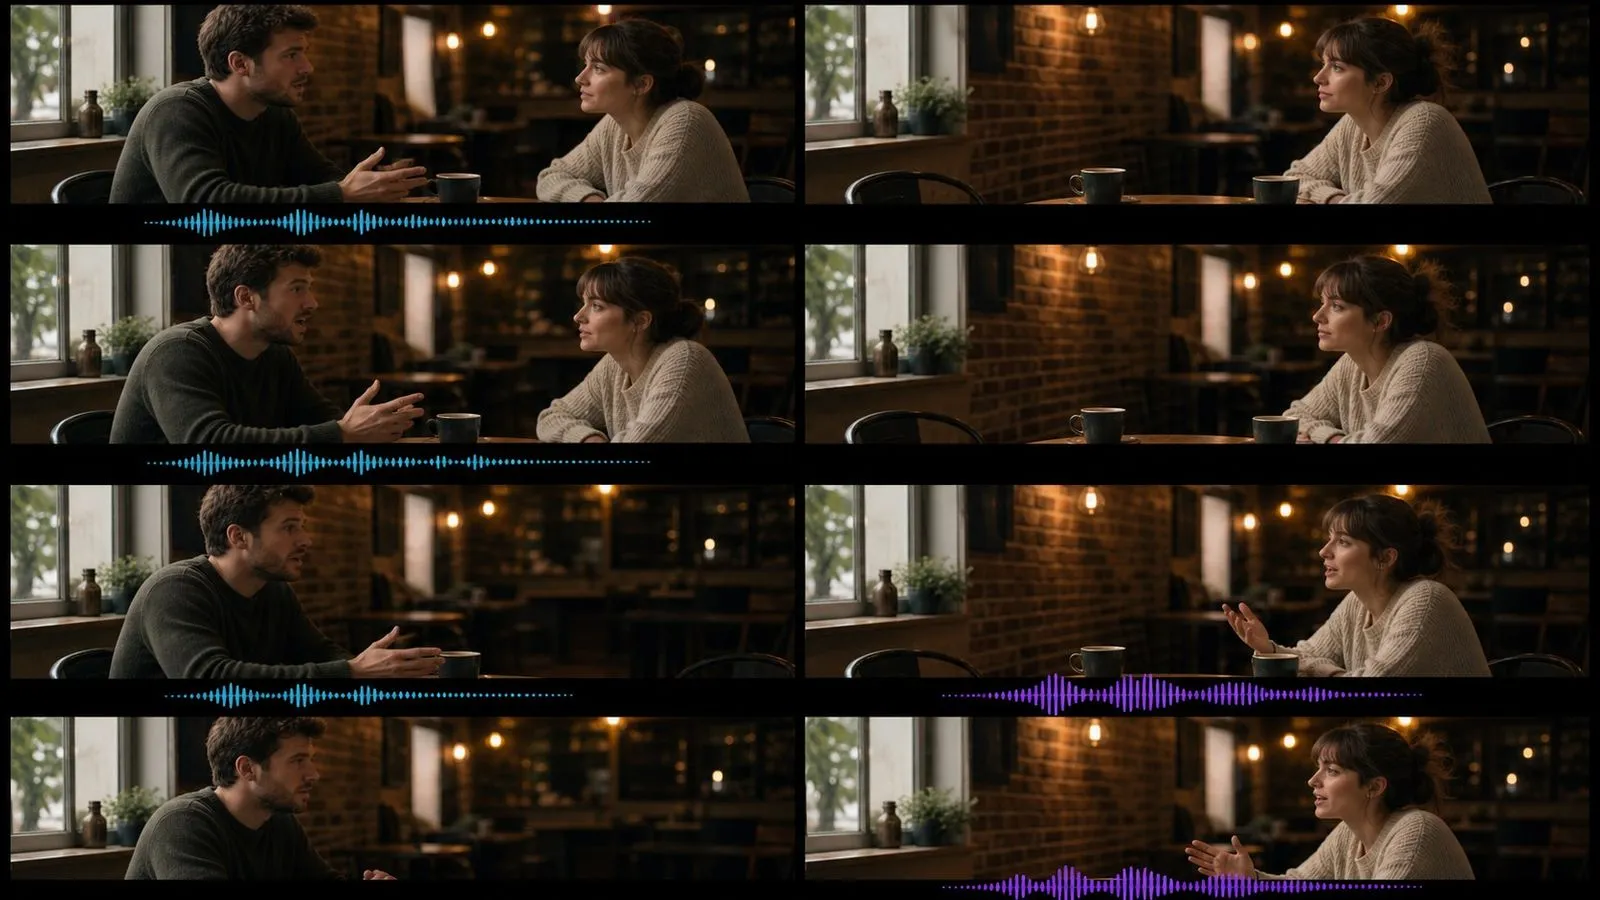
口の動きに後から重ねるのではなく、口の動きに合わせてタイミング調整された音声。
中国語、英語、日本語、韓国語、スペイン語に対応し、混合言語のシーンも含みます。
シーン内の各話者が、それぞれ異なる人物のように聞こえます。
単一パスのクリップ長は、前世代の上限から向上しています。
前バージョンの2倍のフレームレート。
1つのプロンプトから計画される、別々のカメラ設定によるシーケンス。
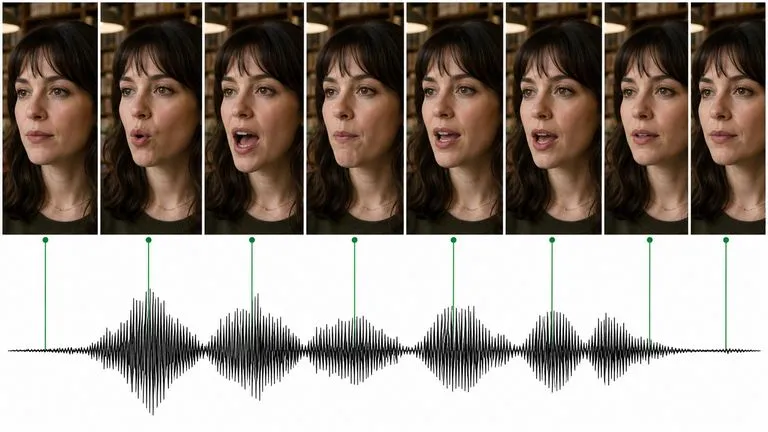
リップシンクは、キャラクターが話しているように見えるか、噛んでいるように見えるかを分ける要素です。Kling 3.0 はセリフのタイミングを見た目の口の動きに合わせるため、会話が単に存在するだけでなく、実用的なものになります。
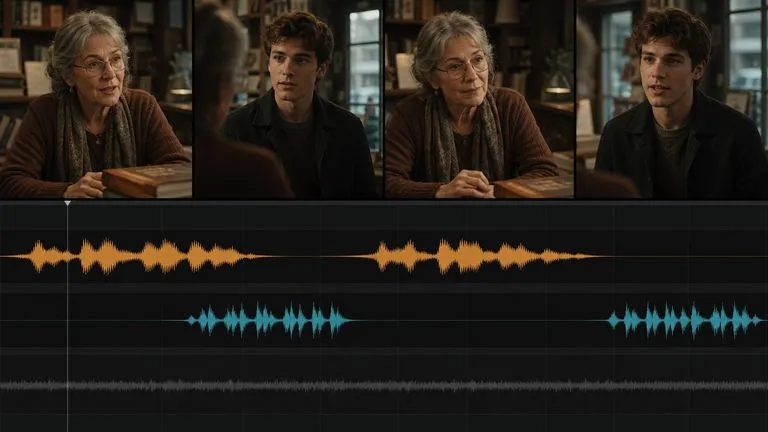
2人芝居で、両者の声が同じに聞こえるのはすぐに不自然だと分かります。キャラクターごとに異なる声を使うことで、生成された会話シーンで最も分かりやすい違和感を取り除けます。
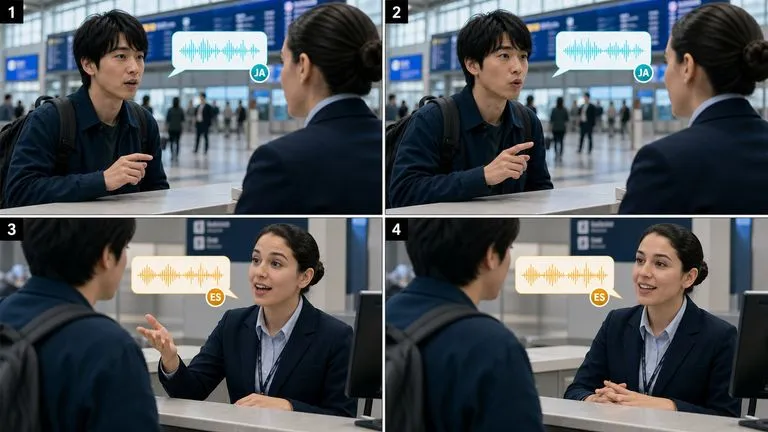
5つの言語に対応しており、1つのシーン内でキャラクターが異なる言語を話すこともできます。これは本当に珍しく、複数市場で展開するキャンペーンに直接役立ちます。
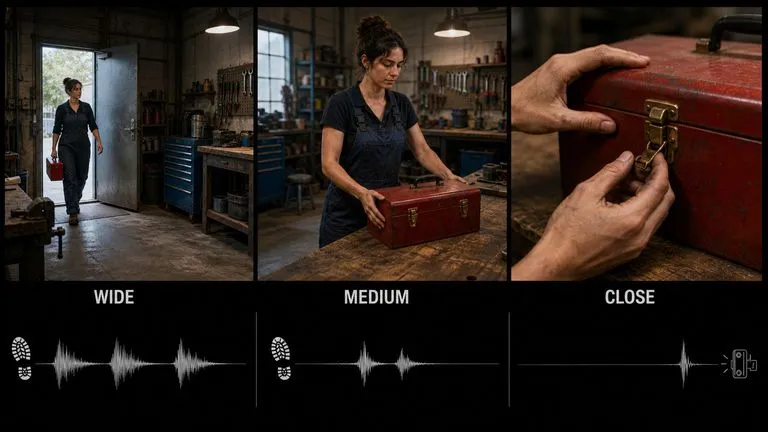
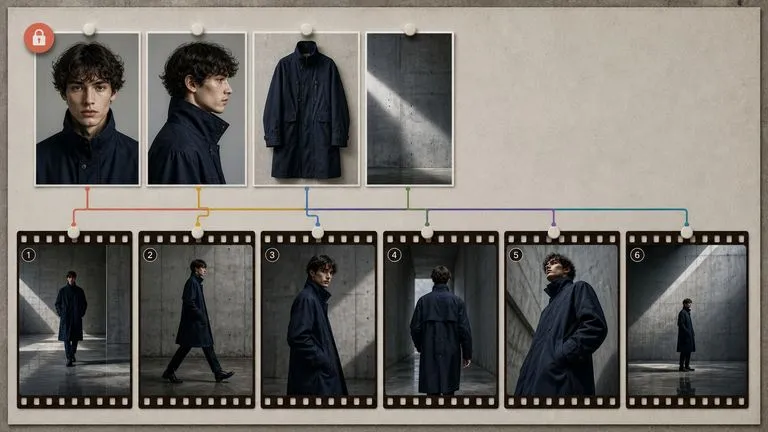
3つのショットを生成してつなぎ合わせるのではなく、マルチショットモードでは1つのプロンプトからシーケンスを設計するため、各セットアップが最初から関連づけられます。
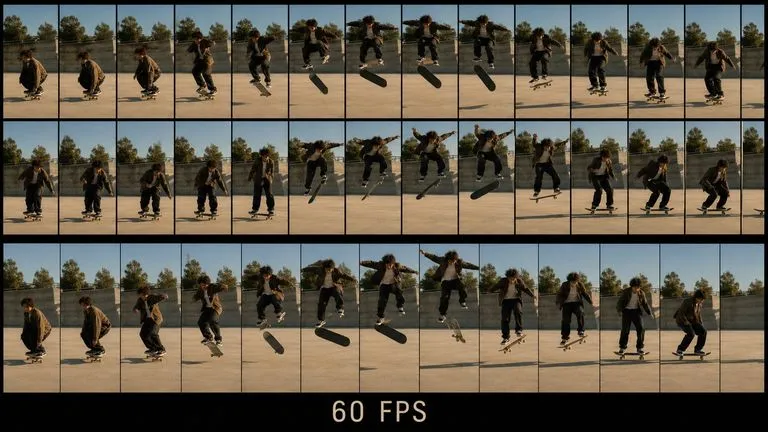
前世代の2倍のフレームレートにより、30fps ではカクつき始める高速な動きやカメラ移動で特に差が現れます。
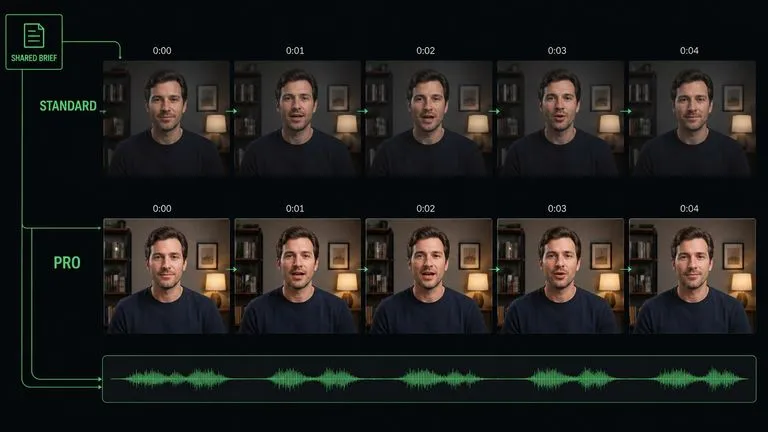
Standard と Pro は同じ入力と同じプロンプトに対応しているため、イテレーションから納品への移行は書き直しではなくクリックだけで済みます。
対話の制作には、無音動画にはないリズムの問題があります。ページ上では自然に読めるセリフでも、実際に話すと4秒かかり、それは生成して初めてわかります。 Virseはスクリプトを出力の横に保持します。書かれた対話、それが再生されるフレーム、そしてすべてのテイクが1つのキャンバス上にあるため、セリフを調整して再実行する作業は、ファイルを探し回るのではなく、その場での編集になります。
生成されたクリップの横に書き起こしたセリフを置いておくことで、タイミングの問題をその原因となった行まで追跡できます。
同じキャンバス上で画像モデルを使って冒頭の構図を作成し、そのまま Kling 3.0 に渡せます。
キャンバスを離れたりブリーフを書き直したりすることなく、Kling 3.0 と 30+ 種類の他の画像・動画モデルを行き来できます。
各市場の言語で同じシーンを生成し、テイクを横に並べて比較できます。
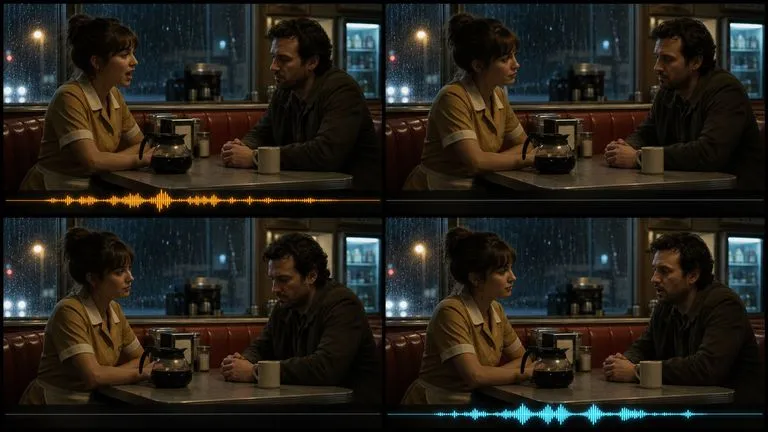
音声を口の動きに合わせ、演技にも一致させる必要がある短いやり取り。
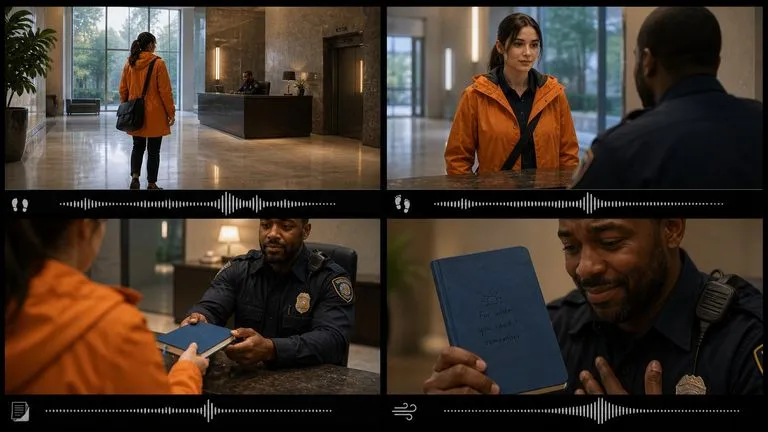
無関係なクリップを組み合わせるのではなく、シーケンスとして設計されたマルチショットの連続シーン。
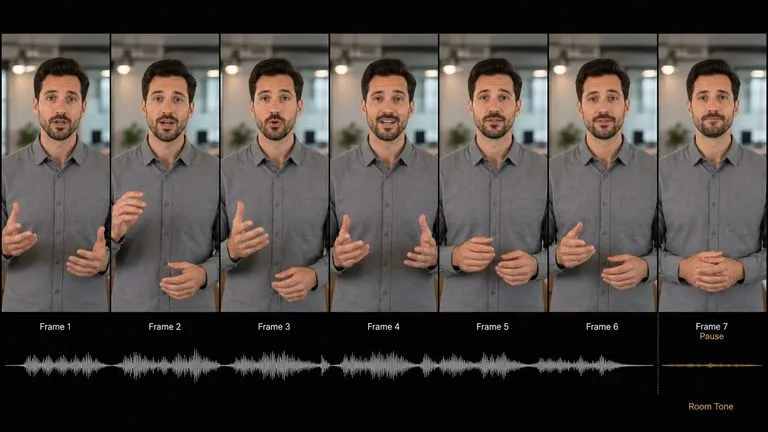
市場が必要とする対応言語のいずれかで、人物がカメラに向かって話すシーン。
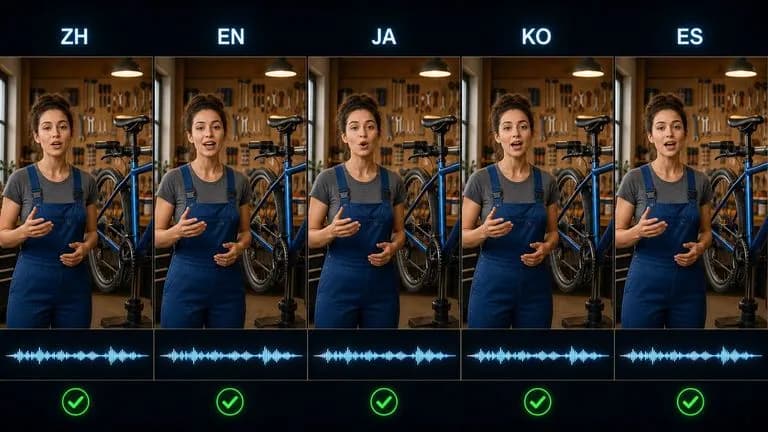
再設計せずに、言語ごとに撮り直した同じシーン。
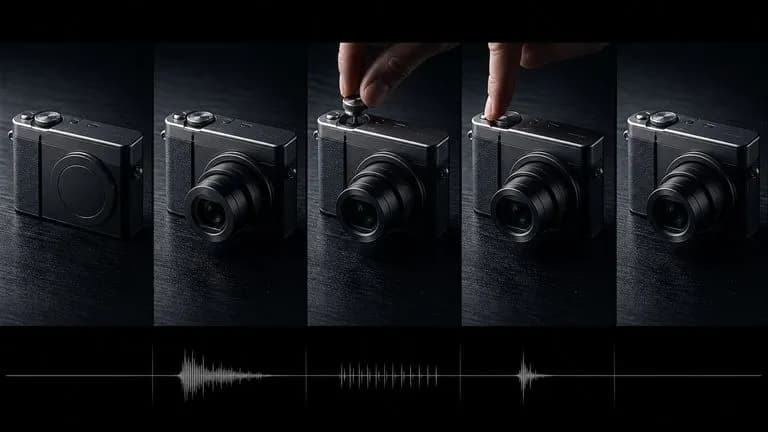
効果や環境音が映像とともに生成される、リビールやデモンストレーション。
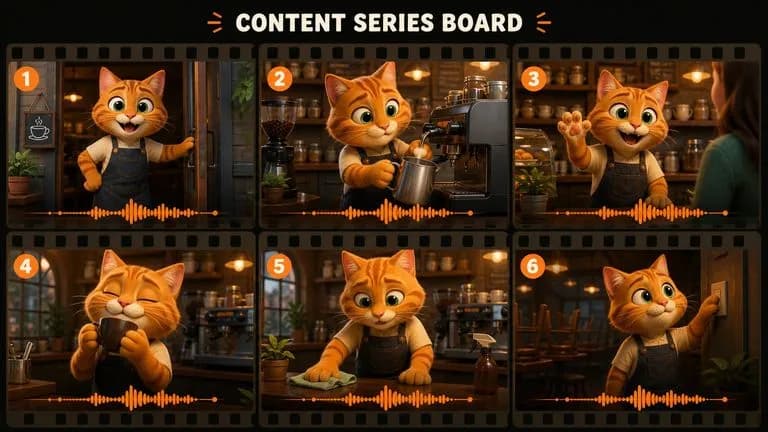
一連の投稿を通じて、短いセリフを話す recurring characters。
シーンを作り込んでいる間はStandard、納品するバージョンにはProを使用します。
開始フレーム、終了フレーム、またはその両方をアップロードします。両端を固定すると、最も予測しやすい結果が得られます。
実際のセリフを引用符で囲み、誰が話すのかを明記します。
画質を見る前に、まずリズムを確認するために一度視聴します。ペーシングの問題は、短い部分の問題です。
有用なKling 3.0プロンプトには、通常5つの要素が含まれます。
こう書く代わりに
店主が客と話している、映画的で自然な会話。
こう書く
書店のカウンターの後ろにいる50代の女性から始まる。カメラに対して横向きで、レシートを整理している。彼女は顔を上げて「あと10分で閉店です」と言い、それからレシートの整理に戻る。客の位置からの固定ミディアムショットで、動きなし。静かな店内の環境音、紙を扱う音、ガラス越しに聞こえる遠くの通りの騒音、音楽なし。最後は彼女が再び頭を下げた状態で終わる。
小さなカフェのテーブルに座る2人を、横から静的なミディアムショットで捉える。 男性が「彼女に言わなかったんだね」と言う。女性は間を置いてから、「言う必要はなかった」と答える。 それぞれの声は明確に異なり、ゆったりとした話し方で、セリフの間に一拍の沈黙を置く。 カフェの環境音、カップの音、低い話し声。音楽なし。女性が視線をそらすところで終わる。
ワークショップでの3ショットのシーケンスを、1つの連続したシーンとして計画する。 ショット1:ワイド、女性が出入口から入ってくる。ショット2:ミディアム、彼女が工具箱を作業台に置く。ショット3:クローズ、彼女の手がラッチを開ける。 一貫した頭上照明と、全体を通して同じキャラクター。 ワークショップの環境音、足音、そして最後のショットでラッチがカチッと鳴る音。セリフなし、音楽なし。
柔らかくぼけたオフィスの背景を背に、無地のグレーのシャツを着た男性が立っている。腰から上のフレーミングで、カメラの方を向いている。 彼は「今四半期に変わったことが3つありますが、計画されていたのはそのうち1つだけでした」と言う。 カメラは固定で、動きなし。正面左から均一で柔らかなキーライト。 静かな室内音のみで、音楽や背景の話し声はない。最後は彼が口を閉じて間を置く。
| 比較項目 | Kling 3.0 Standard | Kling 3.0 Pro |
|---|---|---|
| 対象 | コスト効率の高い反復作業 | 最終品質の出力 |
| 入力 | Proと同一 | Standardと同一 |
| 対話サポート | はい | はい |
| ストーリーボードモード | はい | はい |
| 音声 | 任意、別料金 | 任意、別料金 |
| 一般的な用途 | ブロッキングのタイミングと演技 | 納品版に使うテイク |
3秒のクリップには、自然なペースで短い文が1つ程度収まります。段落を入れると、モデルは急いで話すか、途中で切り詰めることになります。
それらを3つのレイヤーとして名付けます。1つの文にまとめると、混乱したまとまりのない内容になります。
セリフの前に間を置くことは演出で指定できる選択であり、たいていは音が途切れなく続くよりも伝わりやすくなります。
3つのショットを順番に記述するほうが、モデルに解釈させる必要のある1つの連続テイクに圧縮するより効果的です。
Prepare reference images and visual directions for your next video.
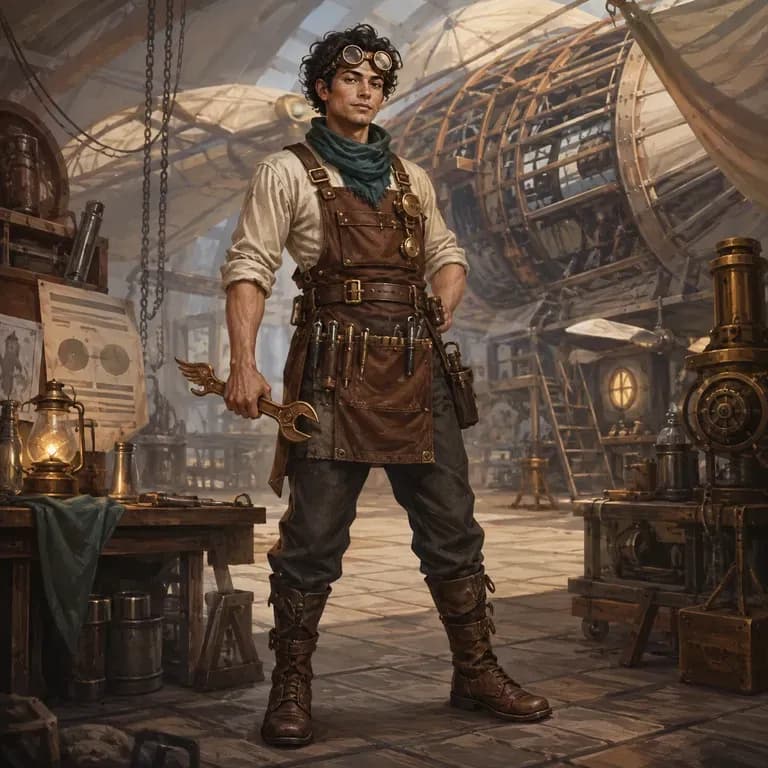
多くのキャラクタープロンプトは、人が読むと問題なく見えても、画像モデルではうまく機能しません。アイデンティティ、世界観、ビジュアルスタイルが、モデルが解析できる1つのまとまりではなく、3つの別々の文に散らばっているからです。どんなキャラクターかを説明し、構造化されたバージョンを生成し、同じキャンバス上で実際のレンダーに対してテストできます。無料クレジットで最初のラウンドをカバーできます。
プロダクトをさりげなく変えてしまうバリエーションは、バリエーションではなく別のプロダクトです。画像を1枚アップロードし、変えるべきなのがシーン、色、またはアングルのどれかを指定すれば、それ以外はすべてそのまま保たれた一括生成結果が返ってきます。無料クレジットで、被写体が実際に一括生成を通して維持されるかを十分にテストできます。
多くのデザインプロンプトは、地味な細部で失敗します。アスペクト比が間違っている、ブランドカラーが抜けている、どのテキストをどこに収めるべきかの記載がない、といったことです。目的、対象読者、形式、制約を列挙すれば、画像モデルがそれらすべてを実際に把握できる構造のプロンプトを作成します。無料のVirseクレジットから始められます。