
립싱크 대화
음성을 단순히 덧씌우는 것이 아니라 입 움직임에 맞춰 타이밍을 조정합니다.
Kuaishou의 Kling 3.0은 말합니다 — 5개 언어의 립싱크 대화, 캐릭터별 서로 다른 음성, 전체 시퀀스를 구성하는 스토리보드 모드를 제공합니다.
데스크톱 브라우저에서 이 페이지를 열어 창작을 시작하세요.
Kling 3.0은 Kuaishou의 3세대 비디오 모델이며, 라인업의 다른 모델들과 차별화되는 기능은 음성입니다.
많은 모델이 사운드를 생성합니다. 하지만 립싱크되는 대화를 생성하는 모델은 훨씬 적고, 각 캐릭터에 고유한 목소리를 부여하고, 5개 언어를 처리하며, 두 사람이 서로 다른 언어로 말하는 장면까지 지원하는 모델은 더욱 드뭅니다. Kling 3.0은 이 모든 것을 영상과 같은 패스에서 수행하며, 하나의 프롬프트로 여러 개의 별도 카메라 설정 시퀀스를 구성하는 멀티샷 스토리보드 모드도 함께 제공합니다.
샷 속 인물이 할 말이 있을 때 Kling 3.0을 사용하세요. 대화 장면, 내러티브 쇼츠, 진행자가 있는 설명 콘텐츠, 다국어 캠페인 버전, 그리고 그렇지 않으면 여러 번의 생성 과정을 거쳐 조립해야 할 멀티샷 시퀀스를 제작할 수 있습니다.
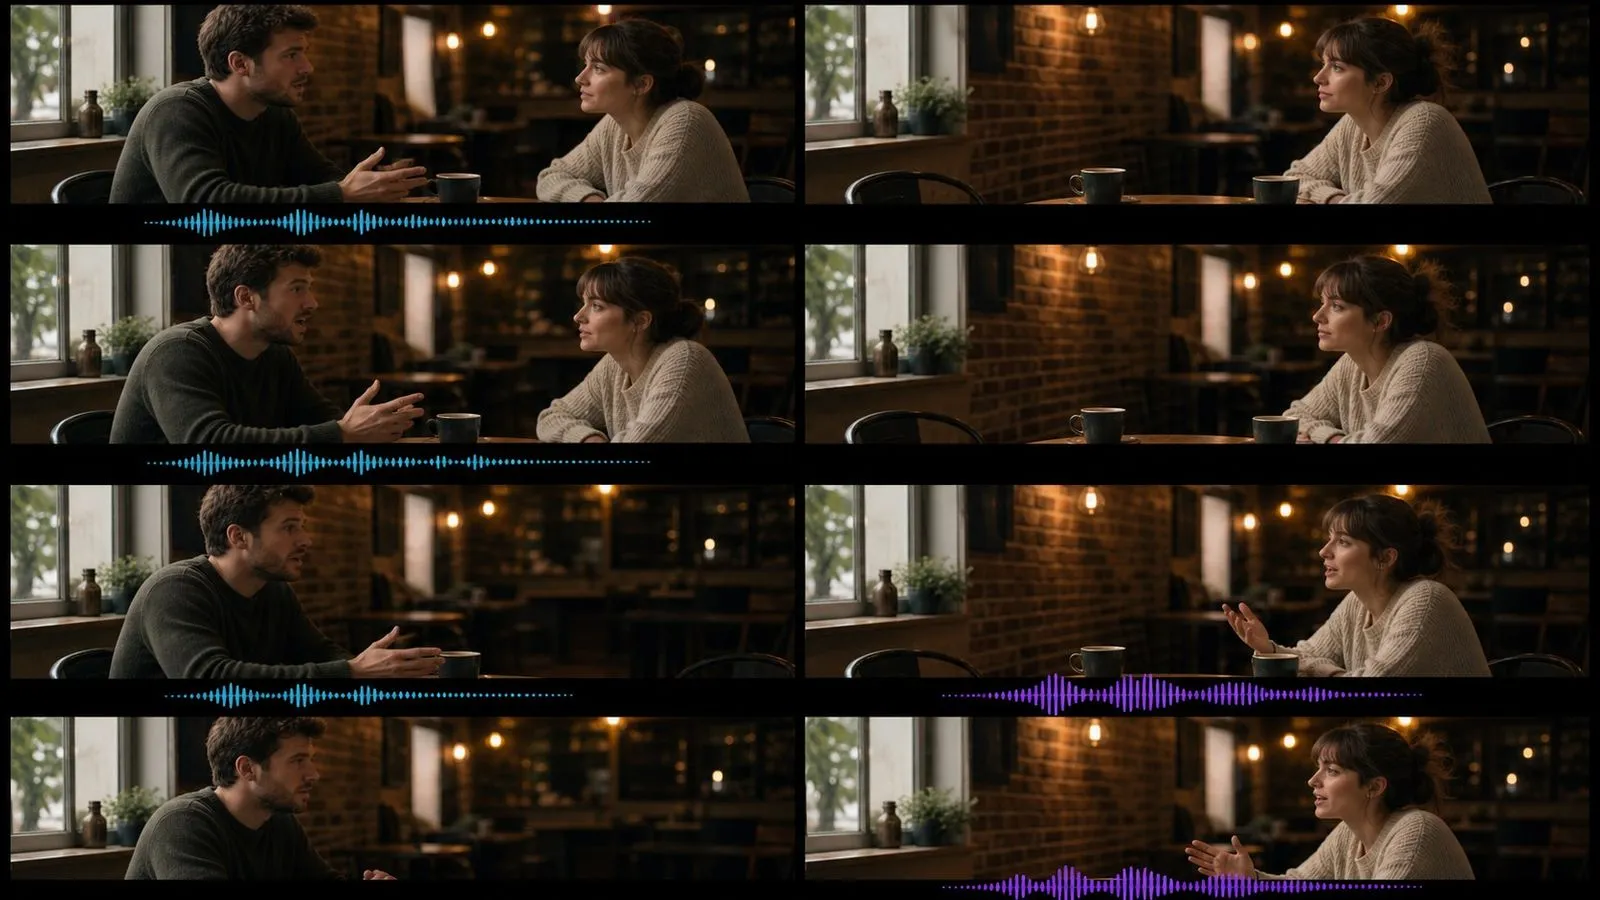
Kling 3.0은 Kuaishou가 개발한 AI 동영상 생성 모델입니다. 시작 프레임, 종료 프레임 또는 둘 다와 함께 그 사이에 어떤 일이 일어나야 하는지에 대한 서면 설명을 입력합니다.
이 모델은 세 가지 주요 강점을 중심으로 구축되었습니다:
클립은 최대 60fps에서 최대 15초까지 실행됩니다. 사운드는 화면과 함께 공동 생성됩니다 — 음악, 효과음, 앰비언스, 음성이 함께 생성됩니다. Virse는 이 라인을 두 가지 항목으로 나열하며, Kuaishou는 Standard를 비용 효율적인 반복 작업용 티어로, Pro를 최종 품질용 티어로 포지셔닝합니다. 둘 다 동일한 입력을 받습니다.
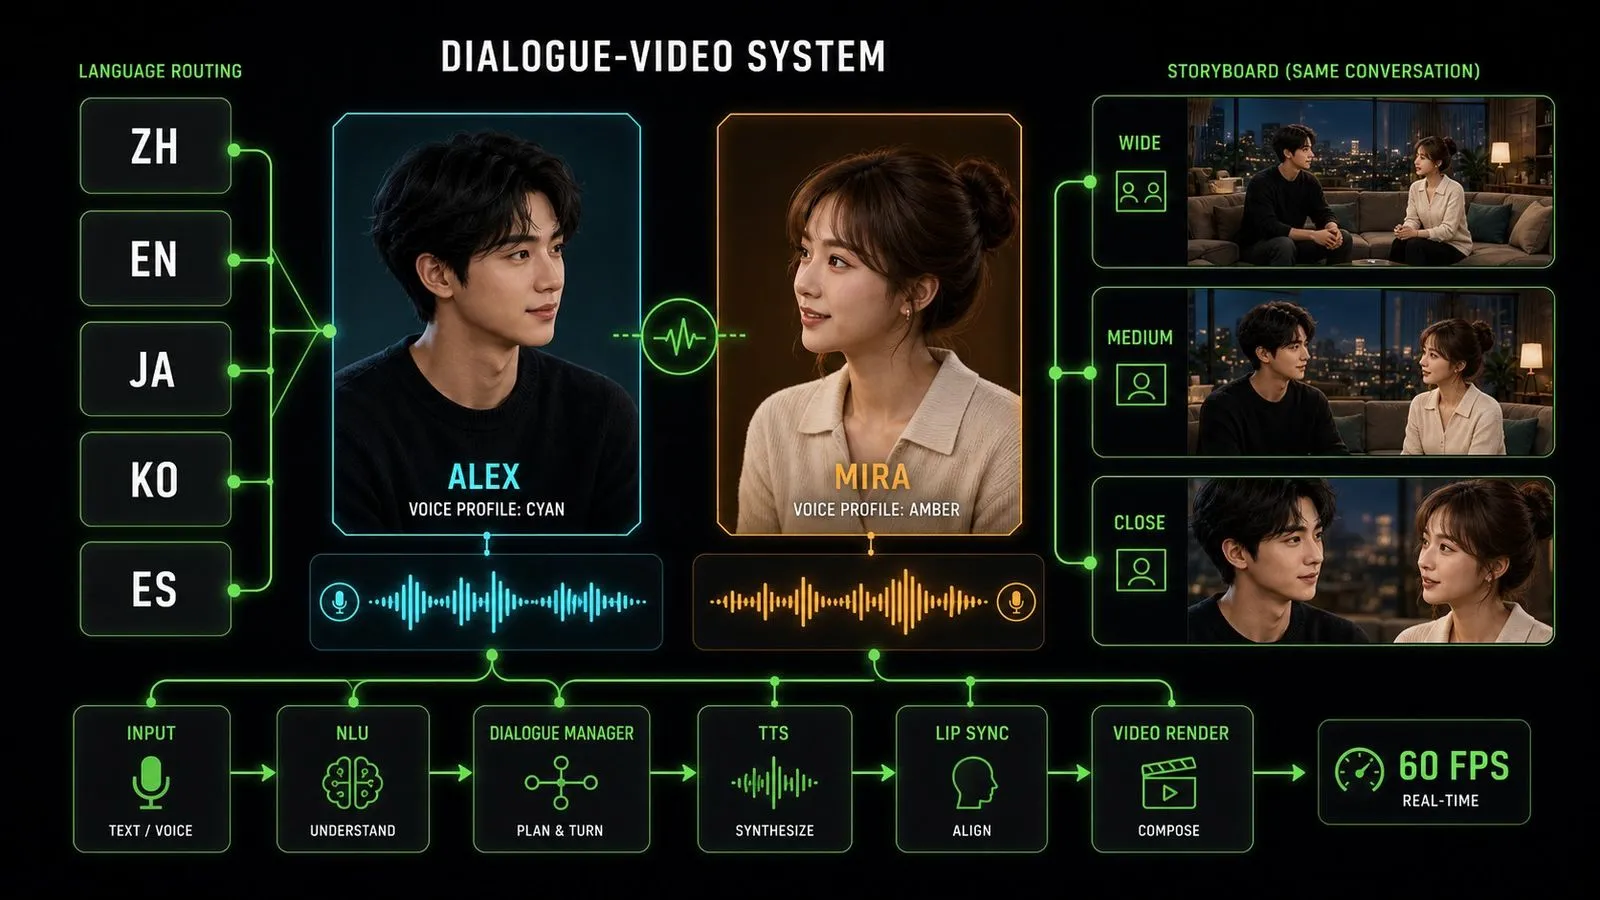
음성을 단순히 덧씌우는 것이 아니라 입 움직임에 맞춰 타이밍을 조정합니다.
중국어, 영어, 일본어, 한국어, 스페인어를 지원하며, 혼합 언어 장면도 가능합니다.
장면 속 각 화자가 서로 다른 사람처럼 들립니다.
이전 세대의 한계보다 늘어난 단일 패스 클립 길이입니다.
이전 버전 대비 두 배의 프레임 속도입니다.
하나의 프롬프트로 계획된 별도의 카메라 설정 시퀀스입니다.
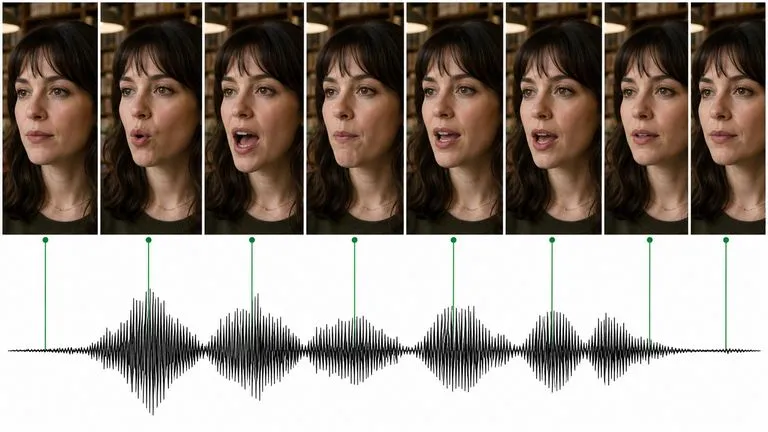
립싱크는 말하는 캐릭터와 씹는 것처럼 보이는 캐릭터를 가르는 차이입니다. Kling 3.0은 전달 타이밍을 눈에 보이는 입 움직임에 맞추며, 바로 이것이 대화를 단순히 존재하는 것이 아니라 실제로 사용할 수 있게 만듭니다.
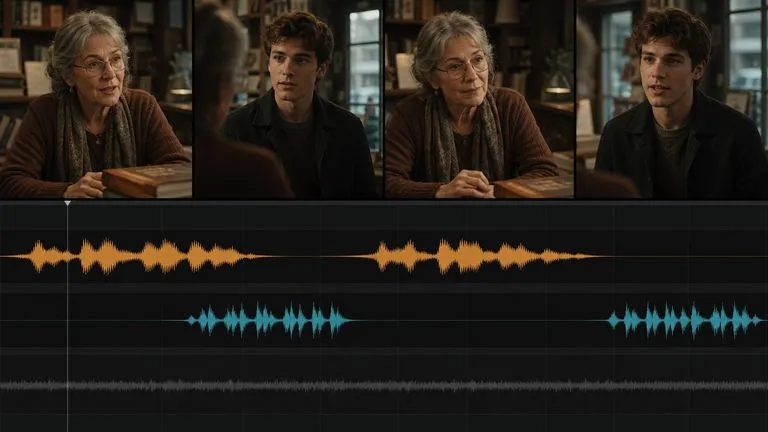
두 인물이 등장하는 장면에서 두 사람의 목소리가 똑같이 들리면 즉시 어색합니다. 캐릭터별로 구분되는 목소리는 생성된 대화 장면에서 가장 명백하게 티 나는 단서를 제거합니다.
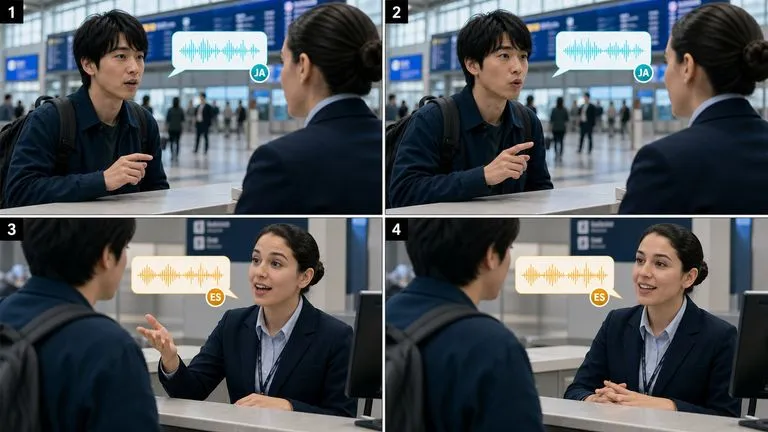
다섯 개 언어가 지원되며, 한 장면 안에 서로 다른 언어를 말하는 캐릭터들을 포함할 수 있습니다 — 이는 실제로 매우 드문 기능이며 여러 시장에 걸쳐 배포되는 캠페인에 직접적으로 유용합니다.
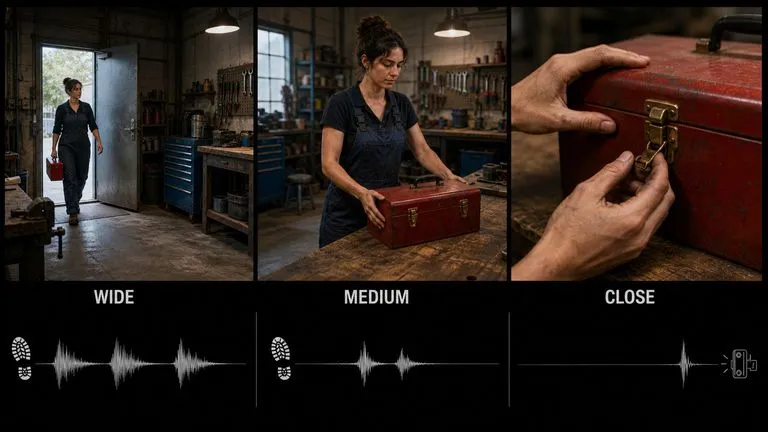
세 개의 샷을 생성한 뒤 이어 붙이는 대신, 멀티샷 모드는 하나의 프롬프트에서 시퀀스를 설계하므로 각 세팅이 의도적으로 서로 연결됩니다.
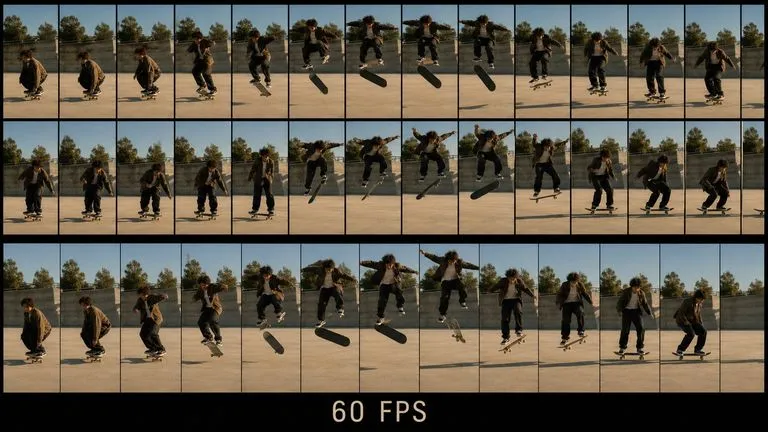
이전 세대보다 프레임 레이트가 두 배 높아져, 30fps에서 버벅임이 시작되는 빠른 동작과 카메라 움직임에서 그 차이가 가장 두드러집니다.
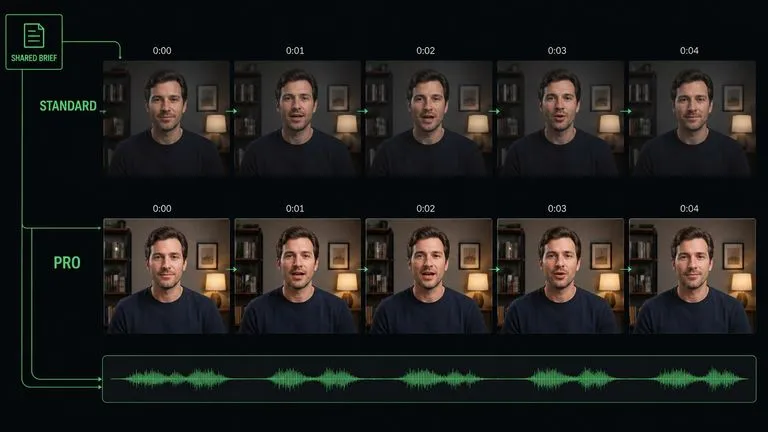
Standard와 Pro는 동일한 입력과 동일한 프롬프트를 사용하므로, 반복 작업에서 납품 단계로 넘어가는 과정이 다시 작성하는 일이 아니라 클릭 한 번으로 끝납니다.
대화 작업에는 무성 비디오에는 없는 리듬 문제가 있습니다. 페이지에서 보기에는 괜찮은 대사도 말로 하면 4초가 걸리고, 그 사실은 생성한 뒤에야 알게 됩니다. Virse는 스크립트를 출력물 옆에 유지합니다. 작성된 대화, 그것이 재생되는 프레임, 모든 테이크가 하나의 캔버스에 놓이므로, 대사를 조정하고 다시 실행하는 작업은 파일을 뒤지는 것이 아니라 그 자리에서 편집하는 일이 됩니다.
작성한 대사를 생성된 클립 옆에 배치해, 타이밍 문제를 그 원인이 된 대사 줄까지 추적할 수 있게 하세요.
같은 캔버스에서 이미지 모델로 오프닝 구도를 만들고 이를 곧바로 Kling 3.0에 넘기세요.
캔버스를 떠나거나 브리프를 다시 작성하지 않고 Kling 3.0과 30개 이상의 다른 이미지 및 비디오 모델 사이를 이동하세요.
각 시장의 언어로 동일한 장면을 생성하고 테이크를 나란히 배치하세요.
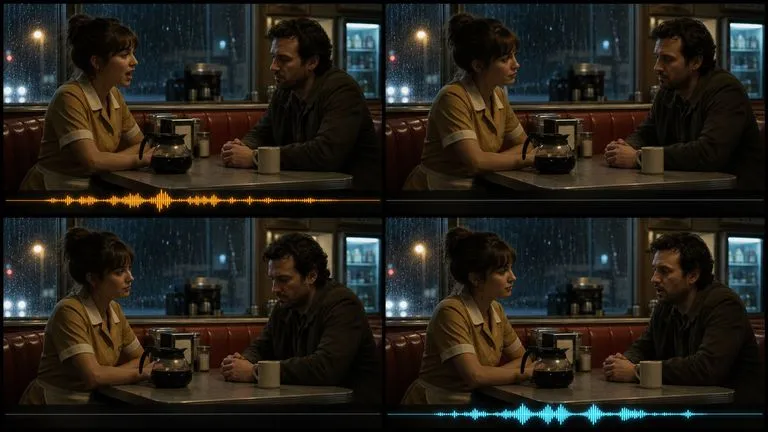
말이 입 모양에 맞아야 하고 연기와도 일치해야 하는 짧은 대화.
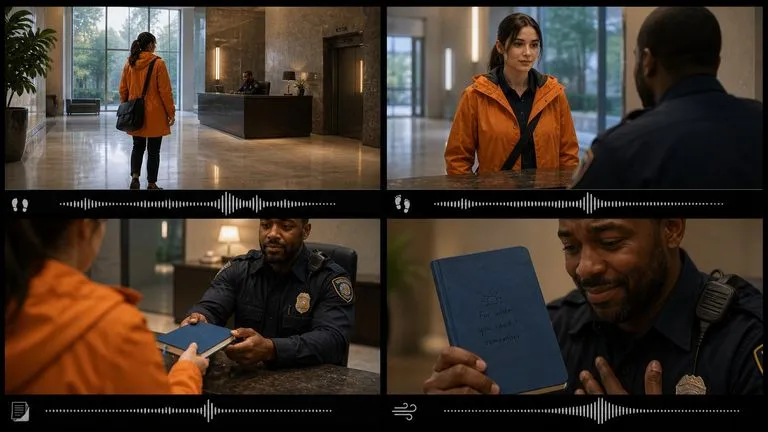
서로 무관한 클립을 조립하는 것이 아니라 하나의 시퀀스로 계획된 멀티샷 시퀀스.
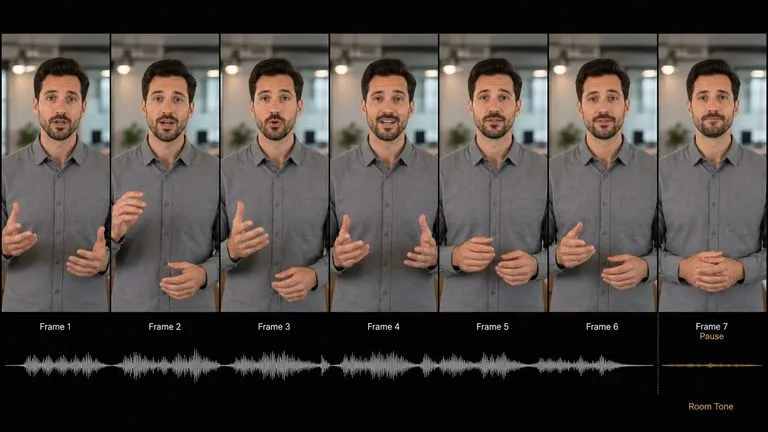
시장이 필요로 하는 지원 언어 중 어느 언어로든 카메라를 향해 말하는 사람.
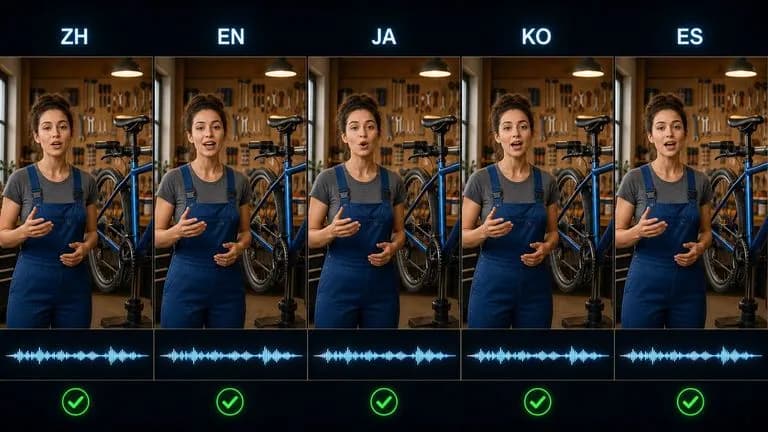
다시 설계하지 않고 각 언어별로 다시 촬영한 동일한 장면.
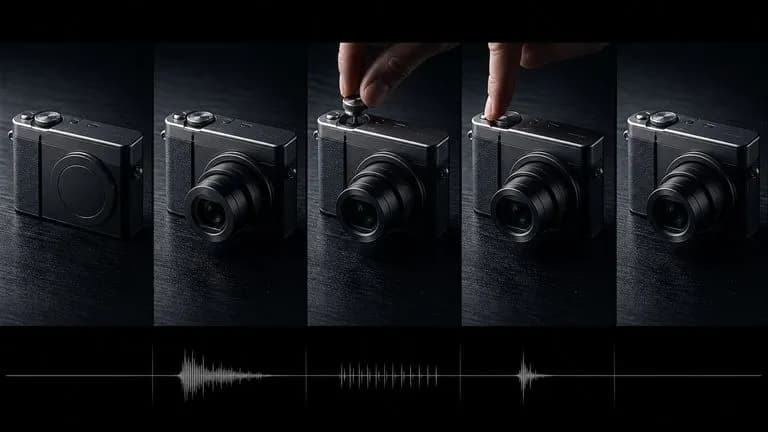
효과와 분위기가 화면과 함께 생성되는 공개 장면과 데모.
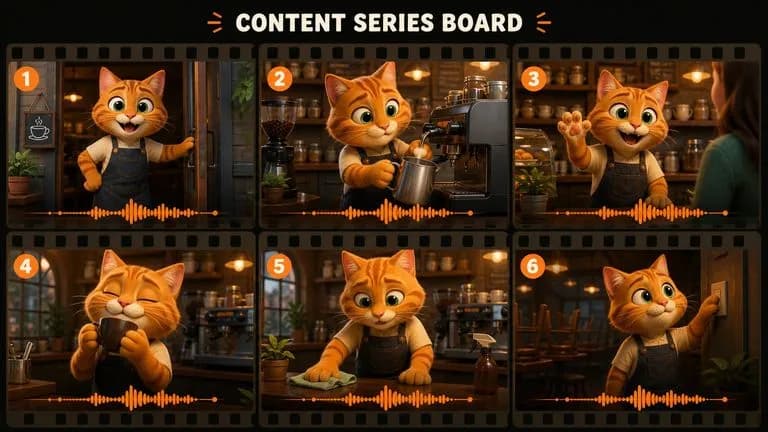
일련의 게시물에서 짧은 대사를 전달하는 반복 등장 캐릭터.
장면을 다듬는 동안에는 Standard를, 최종으로 내보낼 버전에는 Pro를 사용하세요.
시작 프레임, 종료 프레임 또는 둘 다 업로드하세요. 양끝을 모두 고정하면 가장 예측 가능한 결과를 얻을 수 있습니다.
실제 대사를 따옴표 안에 넣고 누가 말하는지 명시하세요.
화질을 보기 전에 리듬을 먼저 한 번 확인하세요. 페이싱 문제는 대개 짧은 구간의 문제입니다.
유용한 Kling 3.0 프롬프트에는 보통 다섯 가지 요소가 포함됩니다.
이렇게 쓰는 대신
고객과 이야기하는 가게 주인, 영화적인 느낌, 자연스러운 대화.
이렇게 쓰세요
서점 카운터 뒤에 있는 50대 여성을 측면에서 보여주며 시작한다. 그녀는 영수증을 정리하고 있다. 그녀가 고개를 들고 '10분 뒤에 문 닫아요'라고 말한 뒤 다시 영수증으로 돌아간다. 고객의 위치에서 촬영한 고정 미디엄 샷, 움직임 없음. 조용한 실내 분위기음, 종이 만지는 소리, 유리창 너머로 들리는 먼 거리 소음, 음악 없음. 그녀가 다시 고개를 숙인 상태로 끝낸다.
작은 카페 테이블에 앉은 두 사람, 측면에서 보이는 고정 미디엄 샷. 남자가 말한다. "그녀에게 말하지 않았잖아." 여자가 잠시 기다렸다가 대답한다. "그럴 필요 없었어." 각 목소리는 뚜렷하게 구분되고, 전달은 서두르지 않으며, 대사 사이에는 한 박자의 침묵이 있다. 컵 소리와 낮은 대화가 섞인 카페 분위기, 음악 없음. 여자가 시선을 돌리는 장면으로 끝난다.
워크숍 안의 3샷 시퀀스, 하나의 연속 장면으로 계획됨. 샷 1: 와이드, 여자가 출입구를 통해 들어온다. 샷 2: 미디엄, 그녀가 공구함을 작업대 위에 올려놓는다. 샷 3: 클로즈, 그녀의 손이 걸쇠를 연다. 전체에 걸쳐 일관된 천장 조명과 동일한 캐릭터. 워크숍 분위기, 발소리, 마지막 샷에서 걸쇠가 딸깍하는 소리. 대사 없음, 음악 없음.
부드럽게 초점이 흐려진 사무실 배경을 등지고 서 있는 평범한 회색 셔츠 차림의 남성, 허리 위로 프레이밍되어 카메라를 바라본다. 그가 말한다. "이번 분기에 세 가지가 바뀌었고, 그중 계획된 것은 하나뿐이었습니다." 카메라 고정, 움직임 없음. 전면 왼쪽에서 비추는 균일하고 부드러운 키 라이트. 조용한 실내 톤, 음악 없음, 배경 목소리 없음. 그가 잠시 멈추고 입을 다문 상태로 끝낸다.
| 비교 항목 | Kling 3.0 Standard | Kling 3.0 Pro |
|---|---|---|
| 적합한 용도 | 비용 효율적인 반복 작업 | 최종 품질 출력 |
| 입력 | Pro와 동일 | Standard와 동일 |
| 대화 지원 | 예 | 예 |
| 스토리보드 모드 | 예 | 예 |
| 오디오 | 선택 사항, 별도 과금 | 선택 사항, 별도 과금 |
| 일반적인 사용 | 동선, 타이밍 및 연기 조율 | 최종으로 내보낼 테이크 |
3초짜리 클립에는 자연스러운 속도로 대략 한 개의 짧은 문장이 들어갑니다. 한 문단을 넣으면 모델이 서두르거나 잘라내게 됩니다.
세 가지 레이어로 나누어 이름 붙이세요. 한 문장으로 묶으면 뒤섞여 모호해집니다.
대사 전에 의도적으로 둔 정적은 연출 가능한 선택이며, 보통 끊임없는 소리보다 더 자연스럽게 읽힙니다.
세 개의 샷을 순서대로 설명하는 것이, 모델이 해석해야 하는 하나의 연속 테이크로 압축하는 것보다 낫습니다.
Prepare reference images and visual directions for your next video.
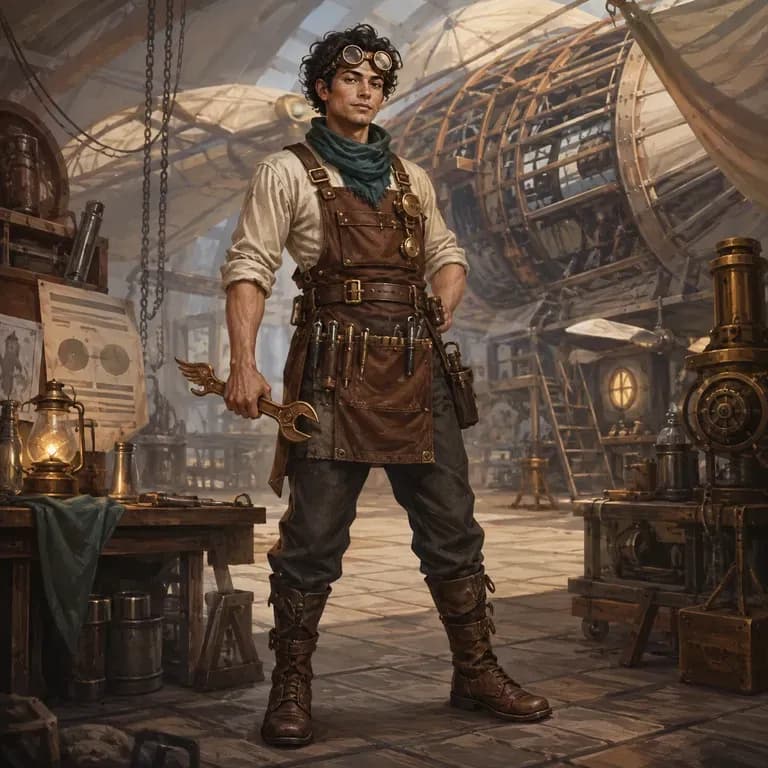
대부분의 캐릭터 프롬프트는 사람이 읽기에는 괜찮지만 이미지 모델에서는 무너집니다. 정체성, 세계관, 시각적 스타일이 모델이 파싱할 수 있는 하나의 문장이 아니라 서로 다른 세 문장에 흩어져 있기 때문입니다. 캐릭터가 누구인지 설명하고, 구조화된 버전을 생성한 뒤, 같은 캔버스에서 실제 렌더로 바로 테스트하세요. 무료 크레딧으로 첫 라운드를 진행할 수 있습니다.
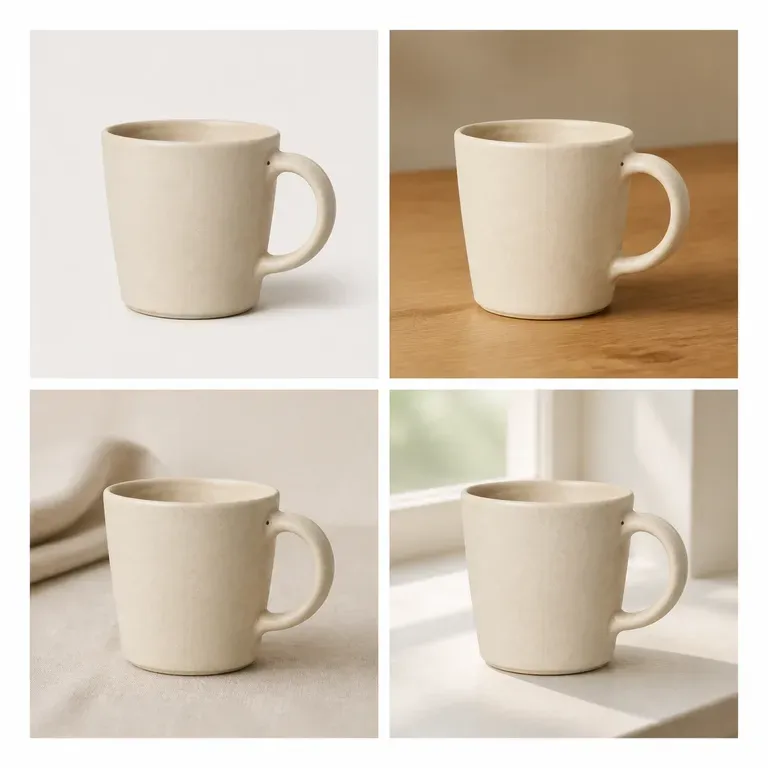
제품을 슬그머니 바꿔 버리는 변형은 변형이 아니라 다른 제품입니다. 이미지 하나를 업로드하고, 장면, 색상 또는 각도 중 무엇을 바꿀지 지정하면 나머지는 그대로 유지된 배치를 받을 수 있습니다. 무료 크레딧만으로도 피사체가 배치 전체에서 실제로 유지되는지 테스트하기에 충분합니다.
대부분의 디자인 프롬프트는 지루해 보이는 세부 사항에서 실패합니다. 잘못된 화면 비율, 빠진 브랜드 색상, 어떤 텍스트가 어디에 들어가야 하는지에 대한 언급 없음 등이죠. 목표, 대상, 형식, 제약 조건을 나열하면, 이미지 모델이 실제로 이 모든 것을 놓치지 않도록 구조화된 프롬프트를 작성해 드립니다. 무료 Virse 크레딧으로 시작할 수 있습니다.
MiniMax's Hailuo 03 model produces silent 2K video, driven either by a first and last frame or by a set of reference images.
동기화된 오디오, 멀티모달 레퍼런스, 정밀한 크리에이티브 제어 기능으로 Seedance 2.5에서 영화 같은 30초 비디오를 생성하세요.
Google DeepMind의 Veo 3.1은 동기화된 48kHz 오디오가 포함된 짧은 클립을 생성하고, 마지막 프레임을 이어받아 더 긴 시퀀스로 확장합니다.