
8ステップ推論
8回のサンプリングステップでレンダリングし、1回まで設定可能です。
60億パラメーターのモデルを8ステップの推論パイプラインに圧縮し、思考の流れが次へ移る前に使える画像を返すよう設計されています。
作成を始めるには、デスクトップのブラウザでこのページを開いてください。
Z-Image Turbo は、標準的な拡散モデルが必要とする20〜50ステップではなく、推論を8ステップに圧縮し、どれだけ品質が残るかを確かめる、という一つの判断を軸に構築されています。
結果として、かなり多くが残ります。公表されている強みは、フォトリアルな出力、英語と中国語のバイリンガルなテキストレンダリング、そして指示への忠実な追従です。これらはいずれも、これほど小さく、これほど高速なモデルが得意とするとは想像しにくいものです。犠牲にしているのは余力であり、能力ではありません。
作業の初期段階で Z-Image Turbo を使ってください。ビジュアルの方向性を探り、アイデアがそもそも伝わるかを試し、レイアウトをプレースホルダーで埋め、きちんと考えるために実際に必要となる大量の使い捨て画像を生成できます。
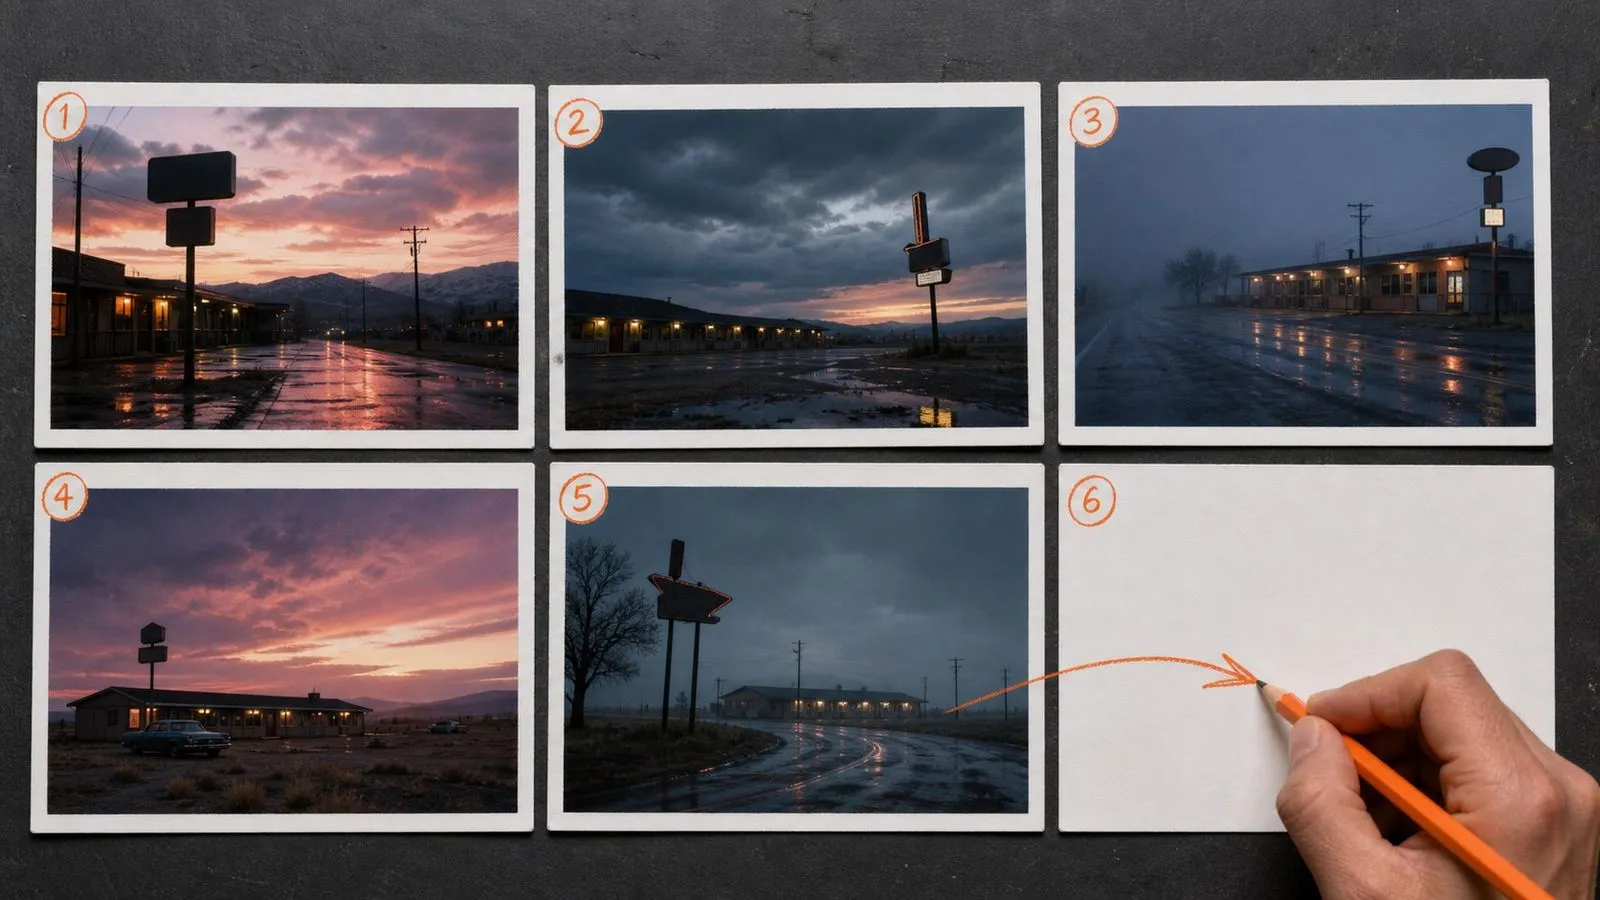
Z-Image Turboは、60億パラメータのテキスト画像生成モデルです。そのアーキテクチャはシングルストリーム拡散トランスフォーマーであり、テキストトークン、セマンティックトークン、画像トークンが別々の分岐で処理されるのではなく、1つのトランスフォーマーを共有します。
このモデルは、主に3つの強みを中心に構築されています:
ステップ数は1まで設定可能で、データセンター向けハードウェアではサブ秒レイテンシを実現できます。重みはオープンに公開されていますが、Virseではインストール不要のホスト型モデルとして動作します。
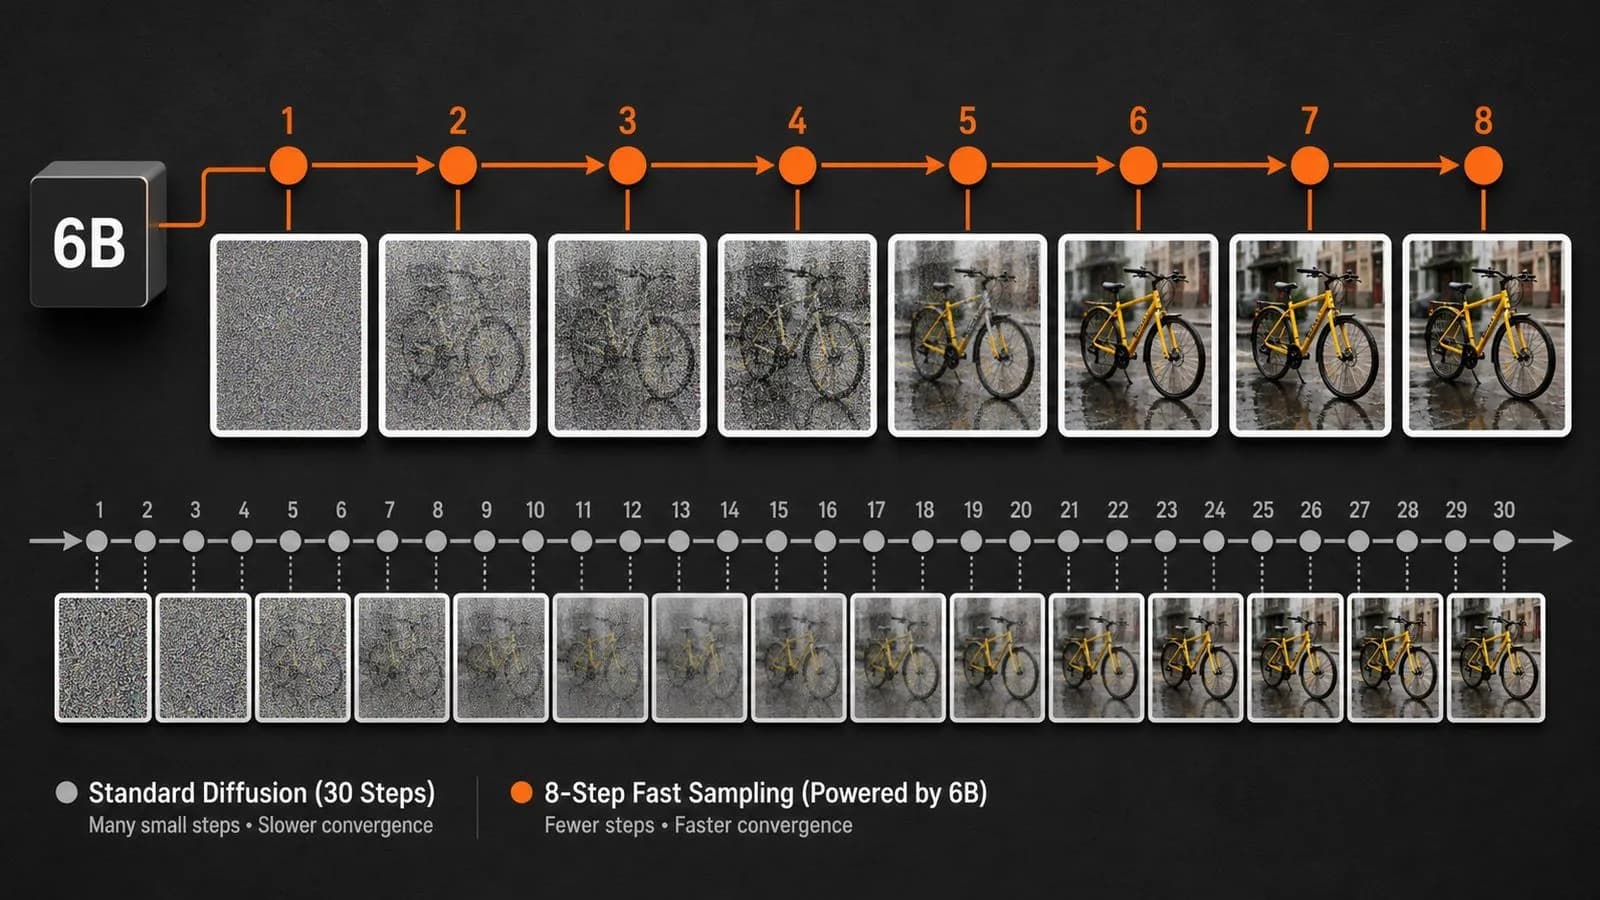
8回のサンプリングステップでレンダリングし、1回まで設定可能です。
データセンターのハードウェアで実現可能であり、それこそが設計全体の狙いです。
意図的に小型化されており、そこから速度が生まれます。
テキスト、セマンティック、画像のトークンは別々の分岐ではなく、1つのTransformerを共有します。
英語と中国語の文字を装飾ではなく言語として扱います。
スタイル化された独自の見た目ではなく、リアルなレンダリングを行います。
通常の20〜50ステップに対する8ステップは、チューニング上の微調整ではなく、アーキテクチャそのものです。このモデルの他のすべては、流れを見失う前に各レンダリングを完了させるという決定から生まれています。
60億パラメータはフラッグシップモデルが備える規模のほんの一部にすぎませんが、フォトリアリズムと指示への追従性はどちらも維持されています。そのトレードオフは、基本的な能力ではなく余力の部分に表れます。
英語と中国語のテキストはどちらも読みやすい言語としてレンダリングされます。高速モデルの中では、これはレイアウトにどちらかの文字体系のラベルが必要な場合に重要になるほど珍しいことです。
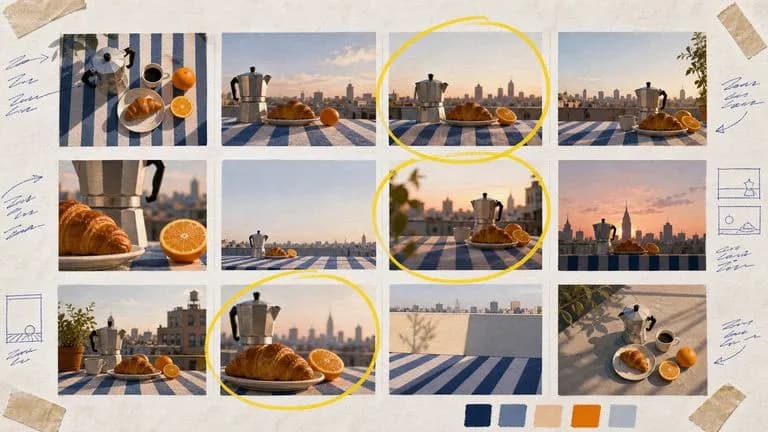
レンダリングが1秒未満で済むなら、6つのセットを生成することは6回の判断ではなく、1回の判断になります。
ここで気に入った構図は、キャンバスを離れることなく、リファレンスとしてより重い画像モデルへ、または冒頭フレームとして動画モデルへ、そのまま送れます。
このモデルはオープンに公開されていますが、Virseでは設定すべき環境なしにホスト型サービスとして実行されます。
高速モデルは、その下流にあるもの次第で初めて有用になります。単体では興味深い存在にすぎませんが、パイプラインの第一段階として使えば、その後のすべての工程の経済性を変えます。 Virseなら、その受け渡しが直接行えます。ここで生成した結果は、エクスポート、リネーム、再アップロードをすることなく、フラッグシップモデルの参照画像や動画モデルの開始フレームにできます。
フラッグシップモデルが2つを生成する時間で30通りの方向性を生成し、生き残ったものだけに本格的な労力をかけられます。
うまくいった構図を、同じキャンバス上でリファレンス画像としてより重いモデルにそのまま送れます。
キャンバスを離れたりブリーフを書き直したりすることなく、Z-Image Turboと30以上の他の画像・動画モデルを行き来できます。
採用されなかった方向性は選ばれたものの横に並べたまま残り、そこから第2ラウンドのアイデアの多くが生まれます。
プロジェクトの開始時に、1つひとつの仕上がりよりも方向性の数が重要なときに行う幅広いビジュアル探索。
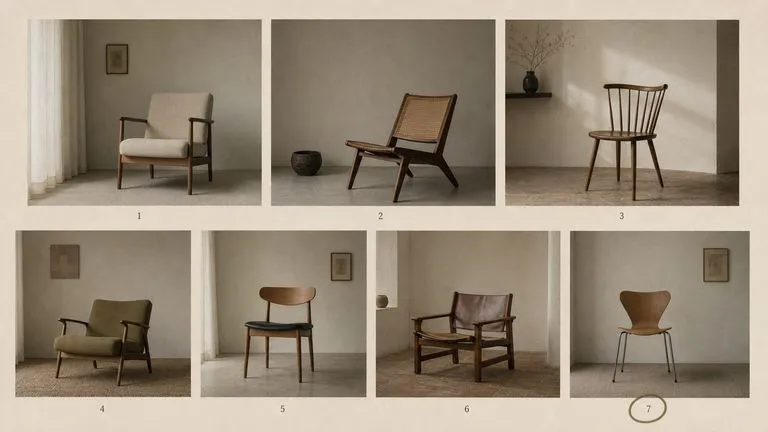
検索結果から寄せ集めるのではなく、1回の作業で一貫したボードを作成できます。
本番の画像が何になるのか誰もまだ決めていない段階で、デザインカンプをおおよそ適切な画像で埋められます。
遅いモデルに時間を費やして確かめる前に、どの文言がどの結果を生むのかを把握できます。
動画モデルが開始点にするフレームを低コストで反復できます。
各画像が例外的であることよりも、妥当であることが求められる投稿ペース。
被写体、設定、表現手法を指定します。この速度では長いブリーフは無駄になります。
一度に6つ実行します。バッチ全体が、フラッグシップモデルのレンダー1回分ほどの時間で返ってきます。
構図、パレット、ムードを比較します。細部の精度は、まだ評価する対象ではありません。
うまくいったプロンプトを、最終版に使うために、より余力のある上位モデルへ持っていきます。
有用なZ-Image Turboプロンプトには、通常3つの要素が含まれます:
こう書く代わりに
ゴールデンアワーの風吹きすさぶ崖の縁に立つ孤独な人物。髪は動きの途中で捉えられ、一本一本の毛筋がリムライトを受けて輝き、風雨にさらされたウールコートには繊維の質感が見える。遠くには海鳥、ボリュメトリックなゴッドレイ、85mm、f/1.4で撮影。
こう書く
夕暮れの崖の縁に立つ人物を背後から捉えたワイドショット。暖かい低い光。絵画的で落ち着いた色彩。
夕暮れ時の小さな麺料理店の正面。通りの向かいから真正面に見た構図。 ドアの上にある横長の看板にはNORTHSIDE NOODLESと書かれ、その下に半分のサイズで面馆とある。 店内から暖かい光がこぼれ、濡れた舗道がそれを反射している、写真風の表現。
| 比較項目 | Z-Image Turbo | Nano Banana Pro |
|---|---|---|
| パラメータ | 6 billion | フラッグシップ級の規模 |
| 推論ステップ | 8、1まで設定可能 | 標準パイプライン |
| 設計ターゲット | レイテンシ | 出力上限 |
| テキスト描画 | 英語と中国語、短い文字列 | 長い文章と多言語レイアウト |
| 参照の扱い | 単一プロンプト駆動 | 役割付きの複数画像ブレンド |
| 適した用途 | 探索とプレースホルダー | 最終アセット、印刷、クライアントワーク |
見るべきものは構図、パレット、ムードです。ディテールは検討対象ではなく、評価に含めるべきではありません。
パターンを見つけられるだけの十分なバリエーションがあり、それを行う価値があるかどうかを考えることがないほど高速です。
それ以上は、8回の推論ステップでは解決できない事柄を記述していることになります。
細部の修正のために再実行する段階になったら、プロンプトを変えるのではなくモデルを切り替えましょう。
デザインアセットの作成、編集、準備に特化したツールをご覧ください。
1枚の写真をアップロードするだけで、シーン、服装、トーンがそれぞれ異なる、スタジオ品質のプロフェッショナルなヘッドショット一式を取得できます。顔はそのまま保たれます。トレーニング手順は不要で、事前に画像を大量に集める必要もありません。
商品写真の背景を、色名、HEX、またはカラー参照画像で指定した均一な単色に置き換えます。商品自体は変更せず、自然な接地影ときれいなエッジを保ちます。規定に準拠した純白の商品掲載用写真や、シーン/ライフスタイル背景の置き換えには適していません。
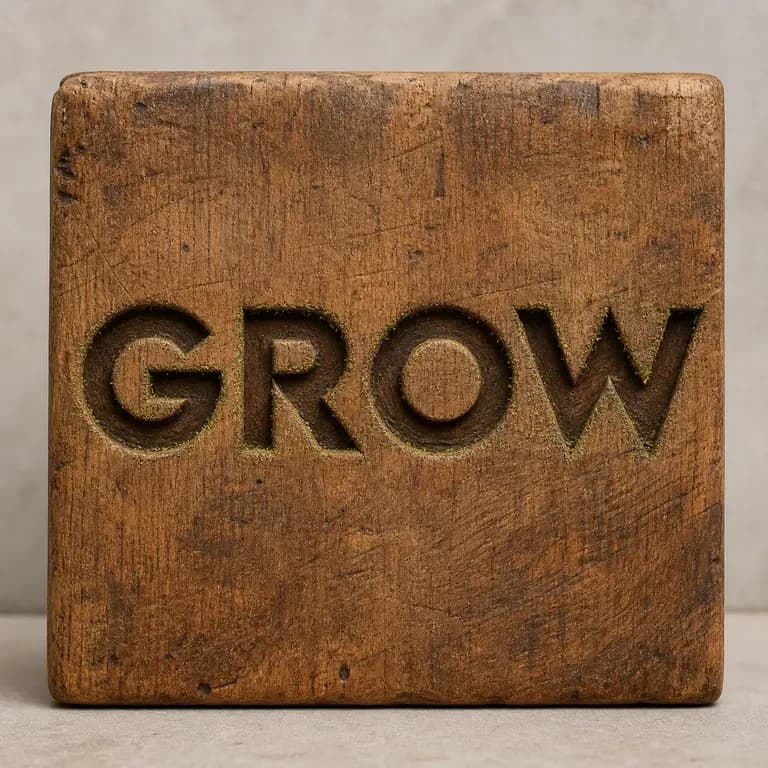
木に彫り込まれた文字は、液体金属で鋳造された文字とは光の下で異なる振る舞いをします。そして、1つのプロンプトだけで偶然その両方を正しく表現することはできません。テキストを入力し、素材を指定すれば、文言をそのまま保ちながら、その素材が実際にどのように光を受けるべきかを導き出した効果が返ってきます。無料クレジットで最初のバージョンを作成できます。
Google's Nano Banana 2 pairs flagship-level image quality with Flash-class speed, across four output sizes from rapid 0.5K prototypes to finished 4K.
FLUX 2より前に登場したBlack Forest LabsのFLUXラインの世代で、標準モデルとUltraの2つのエントリーとして引き続き利用できます。
ByteDanceのSeedream 4.0とSeedream 4.5は、文章による説明やユーザーが提供する画像から生成を行い、1枚の元画像をプロジェクトに必要なだけ多様な方向へ展開します。