
Diálogo sincronizado con los labios
Voz sincronizada con el movimiento de la boca, en lugar de superpuesta.
Kling 3.0 de Kuaishou habla: diálogo sincronizado con los labios en cinco idiomas, una voz distinta por personaje y un modo storyboard que estructura una secuencia completa.
Abre esta página en un navegador de escritorio para empezar a crear.
Kling 3.0 es el modelo de vídeo de tercera generación de Kuaishou, y la capacidad que lo diferencia del resto del catálogo es el habla.
Muchos modelos generan sonido. Muchos menos generan diálogos con sincronización labial, y aún menos dan a cada personaje una voz distintiva, gestionan cinco idiomas y admiten escenas en las que dos personas hablan idiomas diferentes. Kling 3.0 hace todo eso en la misma pasada que la imagen, junto con un modo de guion gráfico multip plano que organiza una secuencia de configuraciones de cámara separadas a partir de un solo prompt.
Usa Kling 3.0 cuando alguien en el plano tenga algo que decir. Crea escenas con diálogos, cortos narrativos, contenido explicativo con un presentador, versiones de campañas multilingües y secuencias multip plano que, de otro modo, requerirían varias generaciones para montarse.
Kling 3.0 es un modelo de generación de vídeo con IA desarrollado por Kuaishou. Le proporcionas un fotograma inicial, un fotograma final o ambos, junto con una descripción escrita de lo que debería ocurrir entre ellos.
El modelo se basa en tres grandes fortalezas:
Los clips duran hasta quince segundos a un máximo de 60fps. El sonido se genera conjuntamente con la imagen: música, efectos, ambiente y voz a la vez. Virse presenta la línea como dos opciones, con Kuaishou posicionando Standard como el nivel de iteración rentable y Pro como el de calidad final; ambos aceptan entradas idénticas.
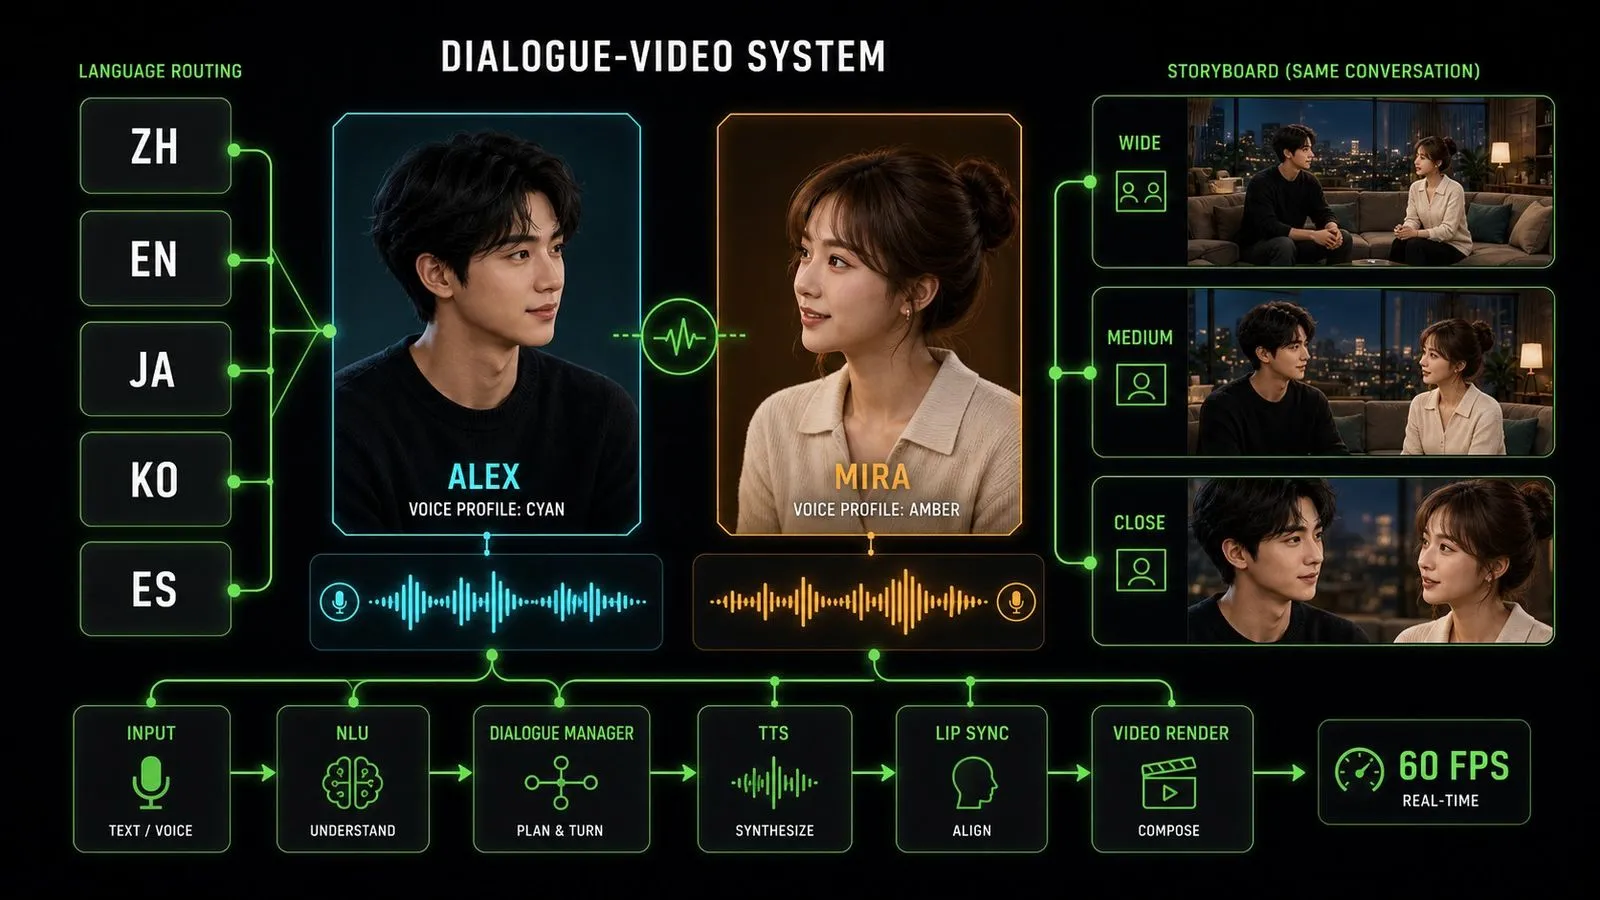
Voz sincronizada con el movimiento de la boca, en lugar de superpuesta.
Chino, inglés, japonés, coreano y español, incluidas escenas con mezcla de idiomas.
Cada hablante de una escena suena como una persona distinta.
Duración del clip en una sola pasada, superior al límite de la generación anterior.
El doble de la frecuencia de fotogramas que la versión precedente.
Una secuencia de configuraciones de cámara independientes planificada a partir de una sola instrucción.
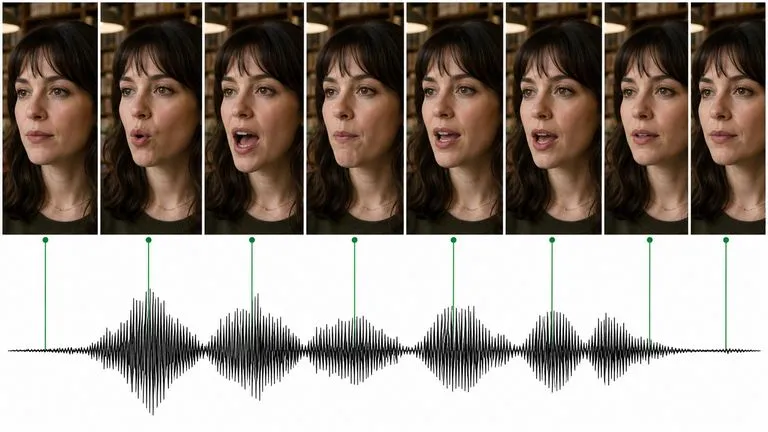
La sincronización labial es la diferencia entre un personaje que habla y uno que parece estar masticando. Kling 3.0 ajusta el momento de la locución al movimiento visible de la boca, que es lo que hace que el diálogo sea utilizable en lugar de simplemente estar presente.
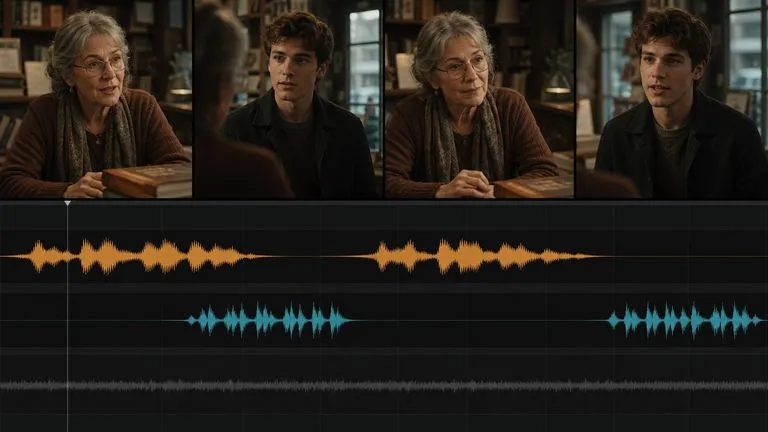
En una escena a dos, que ambas personas suenen igual resulta inmediatamente erróneo. Las voces diferenciadas por personaje eliminan el indicio más obvio en las escenas de diálogo generadas.
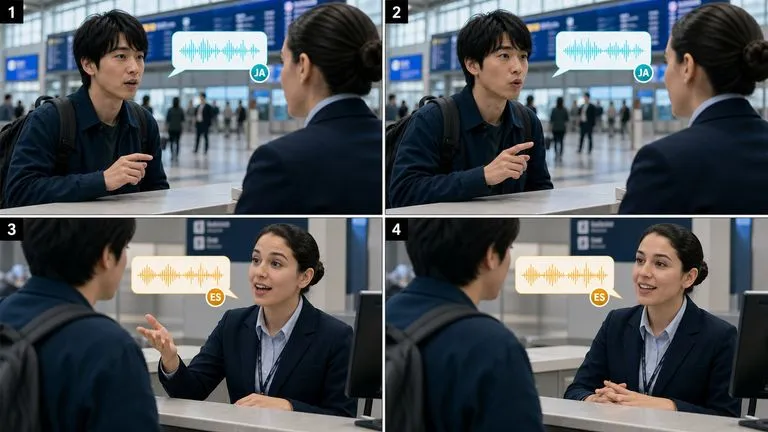
Se admiten cinco idiomas, y una escena puede contener personajes que hablen distintos idiomas — algo realmente inusual y directamente útil para campañas que se lanzan en varios mercados.
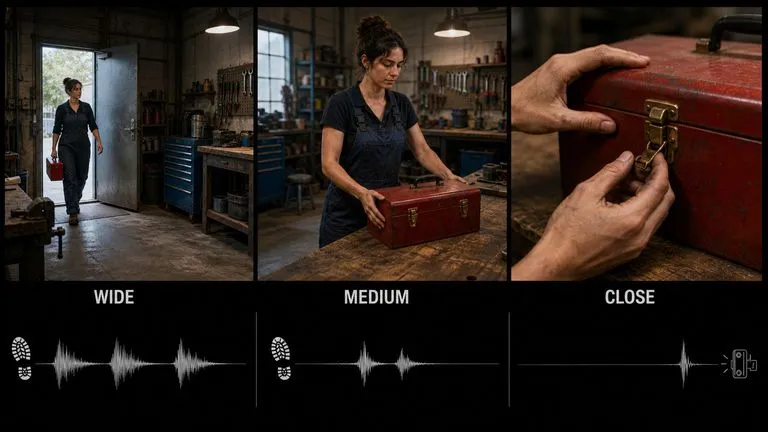
En lugar de generar tres planos y montarlos juntos, el modo multipiano planifica la secuencia a partir de un único prompt, de modo que las configuraciones se relacionan entre sí por diseño.
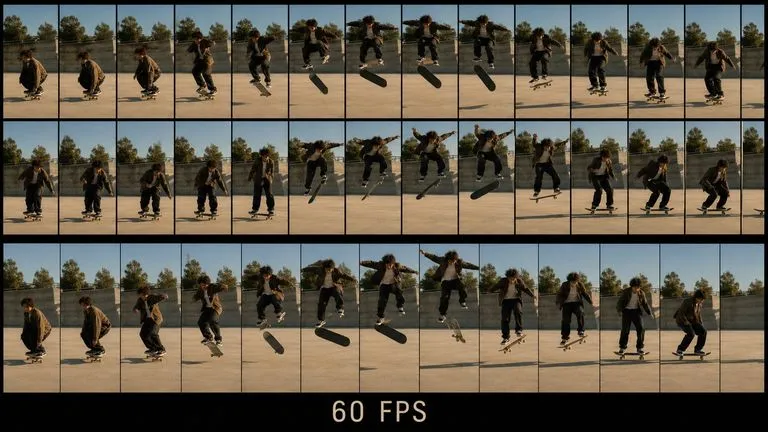
El doble de la frecuencia de fotogramas de la generación anterior, algo que se nota sobre todo en el movimiento rápido y en los movimientos de cámara, donde 30fps empieza a entrecortarse.
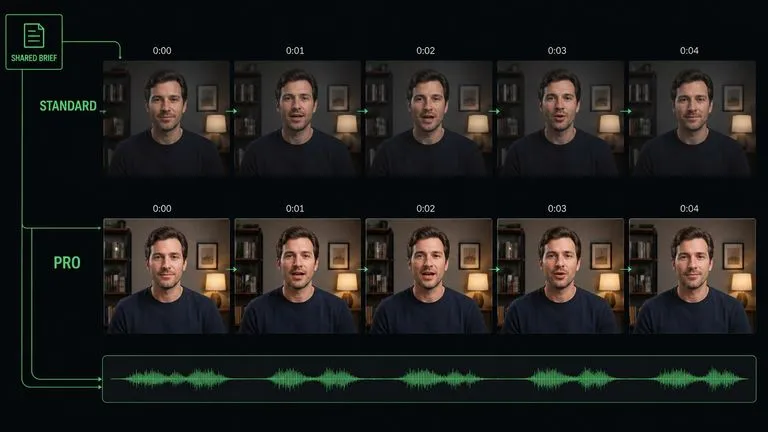
Standard y Pro aceptan las mismas entradas y los mismos prompts, así que pasar de la iteración a la entrega es un clic en lugar de una reescritura.
El trabajo con diálogos tiene un problema de ritmo que el vídeo sin voz no tiene. Una frase que se lee bien en la página tarda cuatro segundos en decirse, y solo lo descubres después de generar. Virse mantiene el guion junto al resultado. El diálogo escrito, los fotogramas sobre los que se reproduce y cada toma están en un mismo lienzo, así que ajustar una frase y volver a ejecutarla es una edición en el mismo lugar, en vez de una búsqueda entre archivos.
Coloca el diálogo escrito junto al clip generado para que los problemas de sincronización puedan rastrearse hasta la línea que los ha causado.
Crea la composición inicial con un modelo de imagen en el mismo lienzo y pásasela directamente a Kling 3.0.
Pasa de Kling 3.0 a más de 30 modelos de imagen y vídeo sin salir del lienzo ni reescribir el briefing.
Genera la misma escena en el idioma de cada mercado y coloca las tomas una junto a otra.
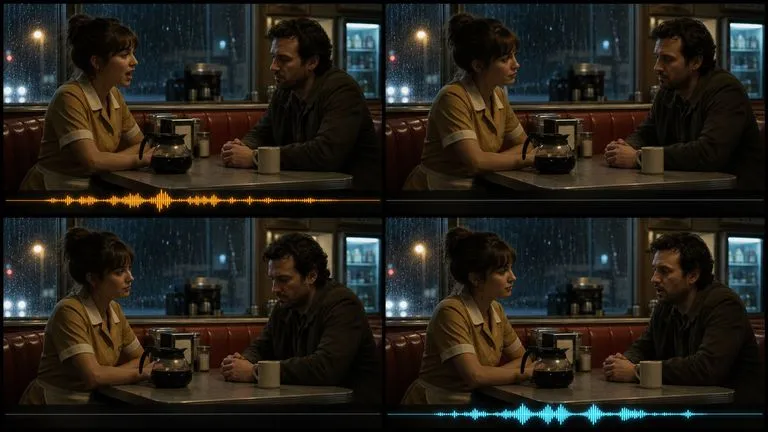
Intercambios breves en los que el habla tiene que coincidir con la boca y encajar con la interpretación.
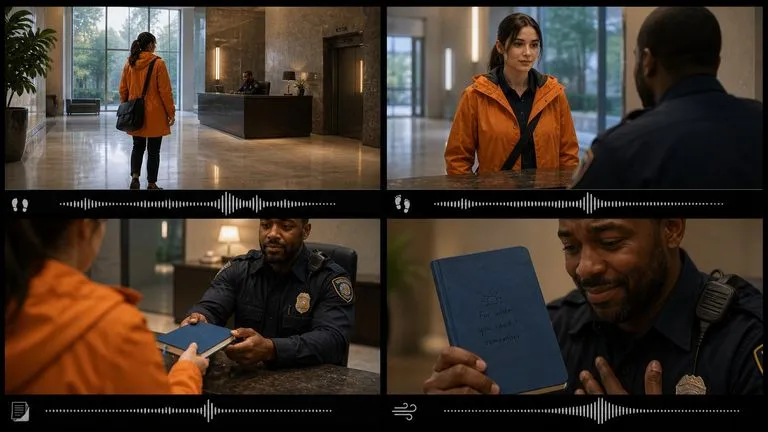
Secuencias multipiano planificadas como una secuencia en lugar de ensamblarse a partir de clips no relacionados.
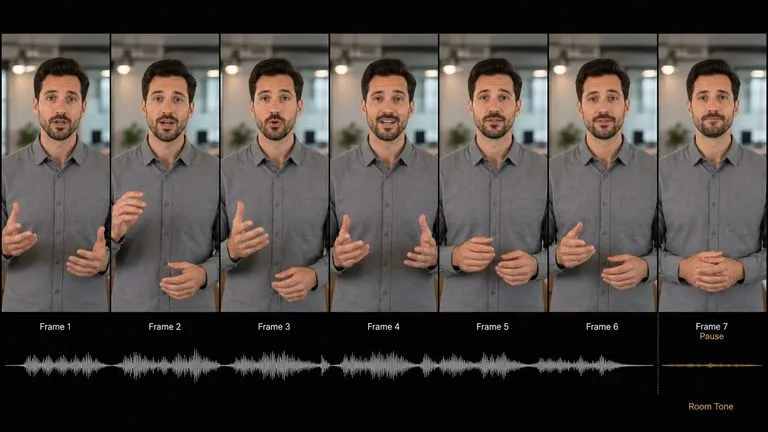
Una persona hablando a cámara, en cualquiera de los idiomas admitidos que necesite un mercado.
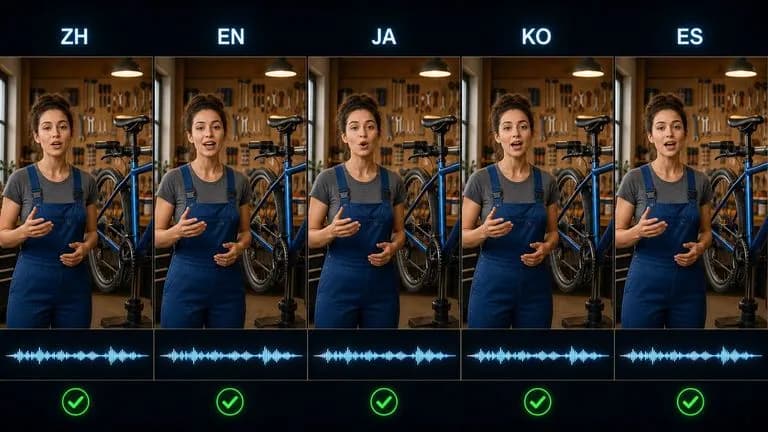
La misma escena rodada de nuevo para cada idioma sin rediseñarla.
Presentaciones y demostraciones en las que los efectos y el ambiente se generan junto con la imagen.
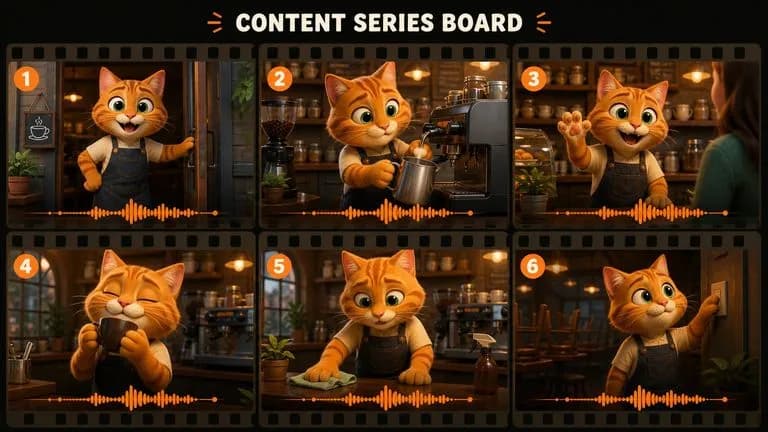
Personajes recurrentes pronunciando frases breves a lo largo de una serie de publicaciones.
Standard mientras estás definiendo la escena; Pro para la versión que se entrega.
Sube el fotograma inicial, el fotograma final o ambos. Fijar ambos extremos ofrece el resultado más predecible.
Pon el diálogo real entre comillas y di quién lo pronuncia.
Míralo una vez para comprobar el ritmo antes de fijarte en la calidad de imagen. Los problemas de ritmo son problemas del brief.
Un prompt útil para Kling 3.0 suele incluir cinco elementos:
En lugar de escribir
Un tendero hablando con un cliente, cinematográfico, diálogo natural.
Escribe
Abre con una mujer de unos cincuenta años detrás del mostrador de una librería, de perfil respecto a la cámara, ordenando recibos. Levanta la vista y dice: 'Cerramos en diez minutos', y luego vuelve a los recibos. Plano medio estático desde la posición del cliente, sin movimiento. Ambiente interior tranquilo, manejo de papeles, ruido lejano de la calle a través del cristal, sin música. Termina con la cabeza de ella bajada de nuevo.
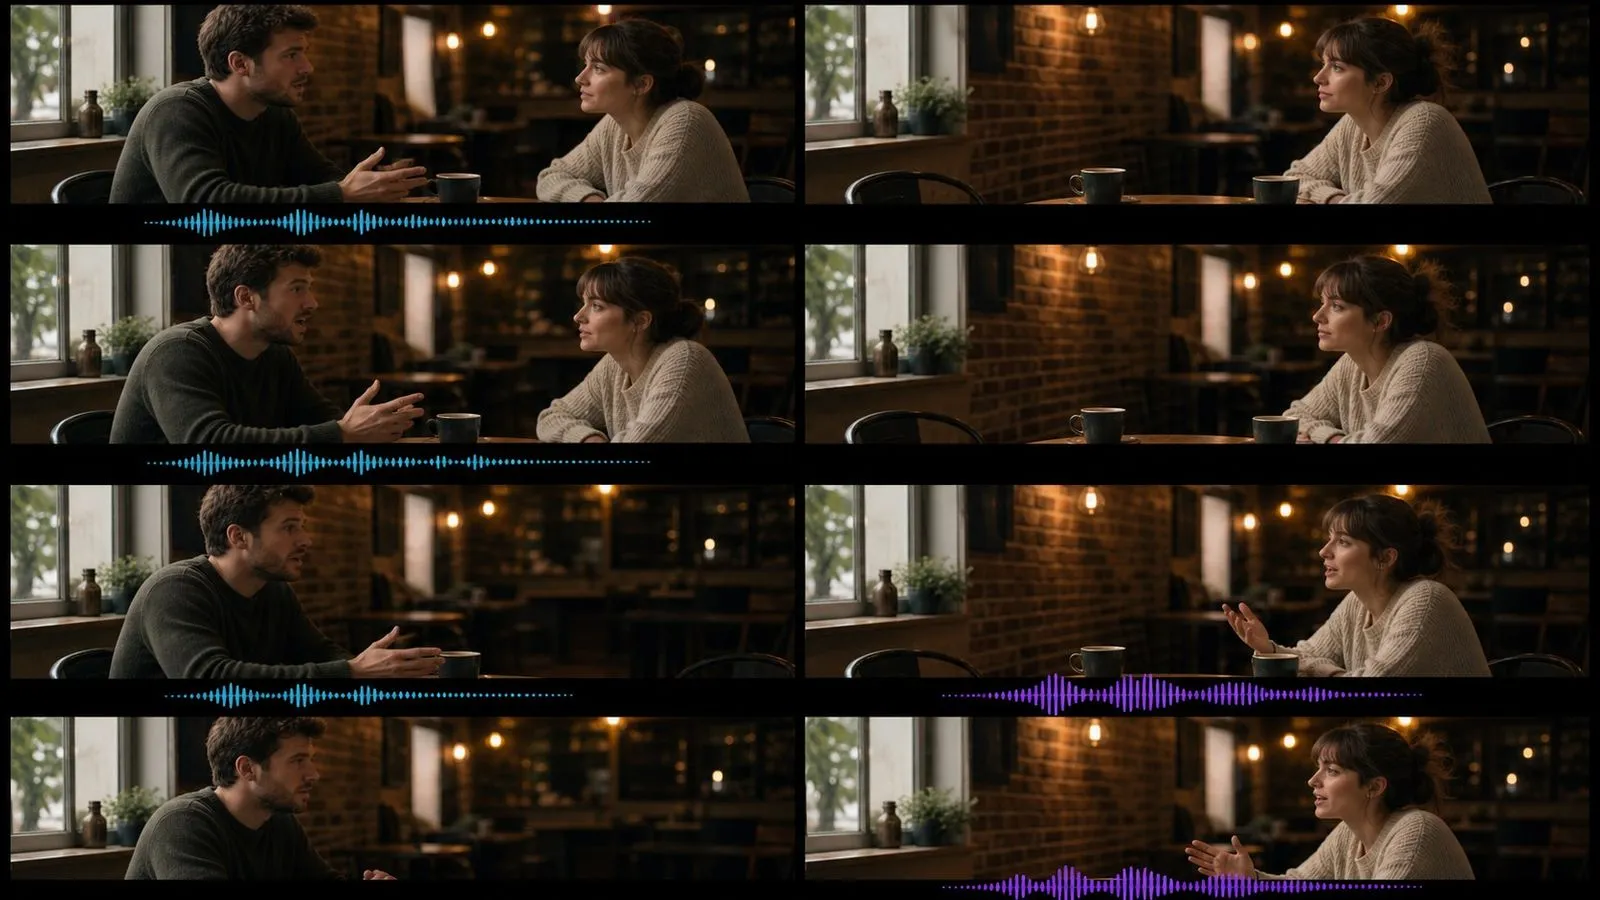
Dos personas en una pequeña mesa de café, vistas de lado en un plano medio estático. El hombre dice: "No se lo dijiste." La mujer espera y luego responde: "No hizo falta." Cada voz distinta, interpretación pausada, un instante de silencio entre las frases. Ambiente de café con tazas y murmullo bajo, sin música. Terminar con la mujer mirando hacia otro lado.
Una secuencia de tres planos en un taller, planteada como una única escena continua. Plano uno: plano general, una mujer entrando por una puerta. Plano dos: plano medio, deja una caja de herramientas sobre el banco. Plano tres: primer plano, sus manos abriendo el pestillo. Iluminación cenital uniforme y el mismo personaje durante toda la secuencia. Ambiente de taller, pasos y el clic del pestillo en el plano final. Sin diálogo, sin música.
Un hombre con una camisa gris lisa de pie contra un fondo de oficina desenfocado suavemente, encuadrado de cintura para arriba, mirando a cámara. Dice: "Han cambiado tres cosas este trimestre, y solo una estaba prevista." Cámara estática, sin movimiento. Luz principal suave y uniforme desde el frente izquierdo. Ambiente de sala silencioso, sin música, sin voces de fondo. Termina con él haciendo una pausa, con la boca cerrada.
| Dimensión | Kling 3.0 Standard | Kling 3.0 Pro |
|---|---|---|
| Pensado para | Iteración rentable | Salida de calidad final |
| Entradas | Idéntico a Pro | Idéntico a Standard |
| Compatibilidad con diálogo | Sí | Sí |
| Modo storyboard | Sí | Sí |
| Audio | Opcional, con precio aparte | Opcional, con precio aparte |
| Uso habitual | Bloqueo del tempo y la interpretación | La toma que se entrega |
Un clip de tres segundos contiene aproximadamente una frase corta a ritmo natural. Un párrafo obliga al modelo a acelerarlo o truncarlo.
Nómbralos como tres capas. Agruparlos en una sola frase produce una mezcla confusa.
Una pausa sostenida antes de una línea es una decisión de dirección, y normalmente se percibe mejor que un sonido continuo.
Describir tres planos en orden es mejor que comprimirlos en una única toma continua que el modelo tenga que interpretar.
Prepare reference images and visual directions for your next video.
La mayoría de los prompts de personajes se leen bien para una persona y se desmoronan ante un modelo de imagen, porque la identidad, el mundo y el estilo visual están dispersos en tres frases distintas en lugar de estar en una que pueda interpretar. Describe quiénes son, genera una versión estructurada y pruébala con un render real directamente en el mismo lienzo. Los créditos gratuitos cubren la primera ronda.
Una variación que cambia discretamente el producto no es una variación, es un producto diferente. Sube una imagen, indica si debe cambiar la escena, el color o el ángulo, y recibe un lote en el que todo lo demás permanece igual. Los créditos gratuitos son suficientes para comprobar si el sujeto realmente se mantiene en todo el lote.
La mayoría de los prompts de diseño fallan en los detalles aburridos: relación de aspecto incorrecta, color de marca omitido, ninguna indicación de qué texto debe encajar dónde. Enumera el objetivo, el público, el formato y las restricciones, y esto escribe un prompt estructurado para que un modelo de imagen realmente tenga en cuenta todo ello, empezando con créditos gratuitos de Virse.
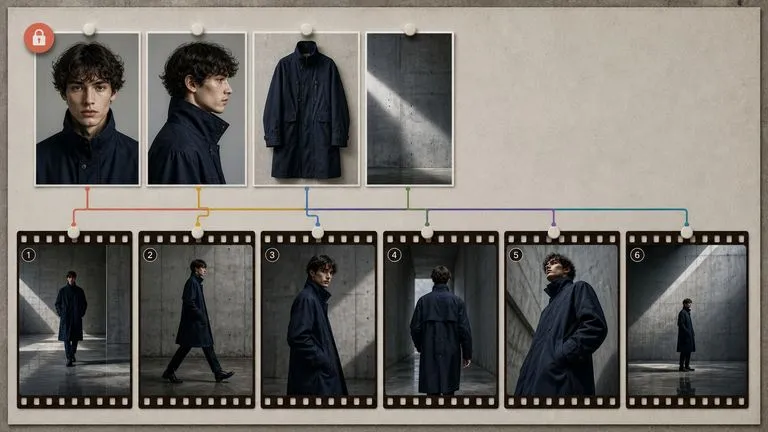
El modelo Hailuo 03 de MiniMax produce vídeo 2K silencioso, impulsado ya sea por un primer y último fotograma o por un conjunto de imágenes de referencia.
Genera vídeos cinematográficos de 30 segundos con Seedance 2.5, con audio sincronizado, referencias multimodales y un control creativo preciso.
Veo 3.1 de Google DeepMind genera clips cortos con audio sincronizado de 48kHz y los amplía en secuencias más largas llevando los fotogramas finales hacia delante.
Escribe la frase, nombra la voz y deja que el modelo se encargue de la boca, el tempo y la sala en la que se pronuncia.