
Dialogue synchronisé sur les lèvres
Parole calée sur le mouvement de la bouche plutôt que simplement superposée.
Kling 3.0 de Kuaishou parle — dialogues synchronisés sur les lèvres en cinq langues, une voix différente par personnage et un mode storyboard qui structure toute une séquence.
Ouvrez cette page sur un navigateur de bureau pour commencer à créer.
Kling 3.0 est le modèle vidéo de troisième génération de Kuaishou, et la capacité qui le distingue du reste de la gamme est la parole.
De nombreux modèles génèrent du son. Beaucoup moins génèrent des dialogues synchronisés avec les mouvements des lèvres, et moins encore donnent à chaque personnage une voix distincte, prennent en charge cinq langues et gèrent des scènes où deux personnes parlent des langues différentes. Kling 3.0 fait tout cela en même temps que l’image, avec un mode storyboard multi-plans qui organise une séquence de configurations de caméra distinctes à partir d’un seul prompt.
Utilisez Kling 3.0 lorsqu’une personne dans le plan a quelque chose à dire. Créez des scènes de dialogue, des courts métrages narratifs, du contenu explicatif avec un présentateur, des versions de campagnes multilingues et des séquences multi-plans qui nécessiteraient autrement plusieurs générations pour être assemblées.
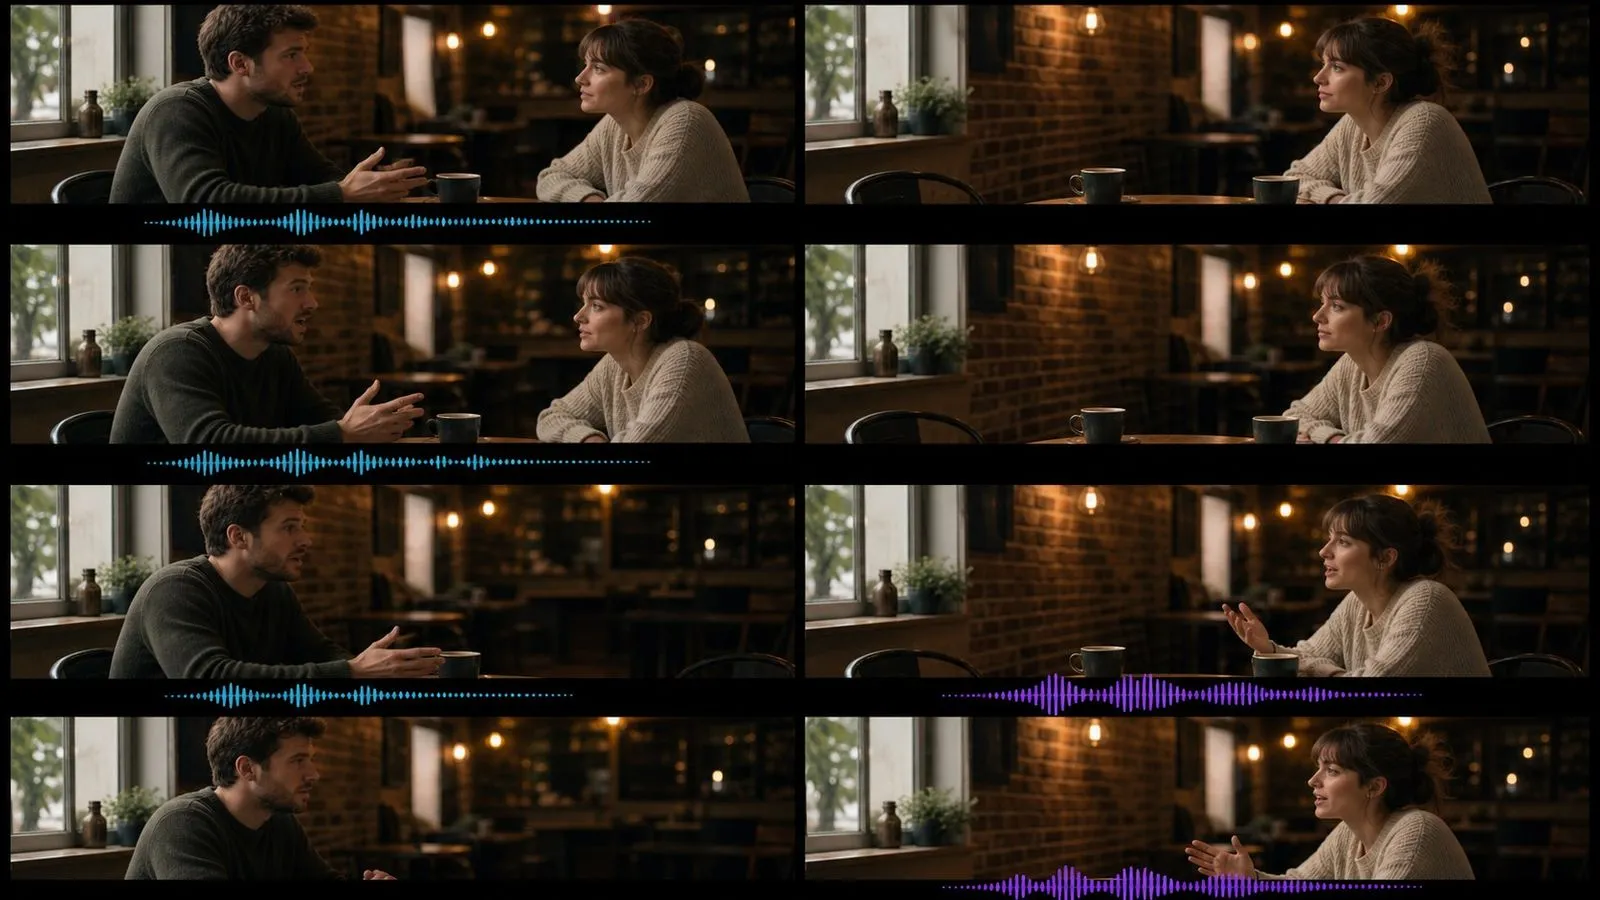
Kling 3.0 est un modèle de génération vidéo par IA développé par Kuaishou. Vous lui fournissez une image d’ouverture, une image de clôture, ou les deux, ainsi qu’une description écrite de ce qui doit se passer entre elles.
Le modèle repose sur trois atouts majeurs :
Les clips durent jusqu’à quinze secondes à jusqu’à 60fps. Le son est co-généré avec l’image — musique, effets, ambiance et parole ensemble. Virse répertorie la gamme sous deux entrées, Kuaishou positionnant Standard comme le niveau d’itération économique et Pro comme celui de la qualité finale ; tous deux acceptent des entrées identiques.
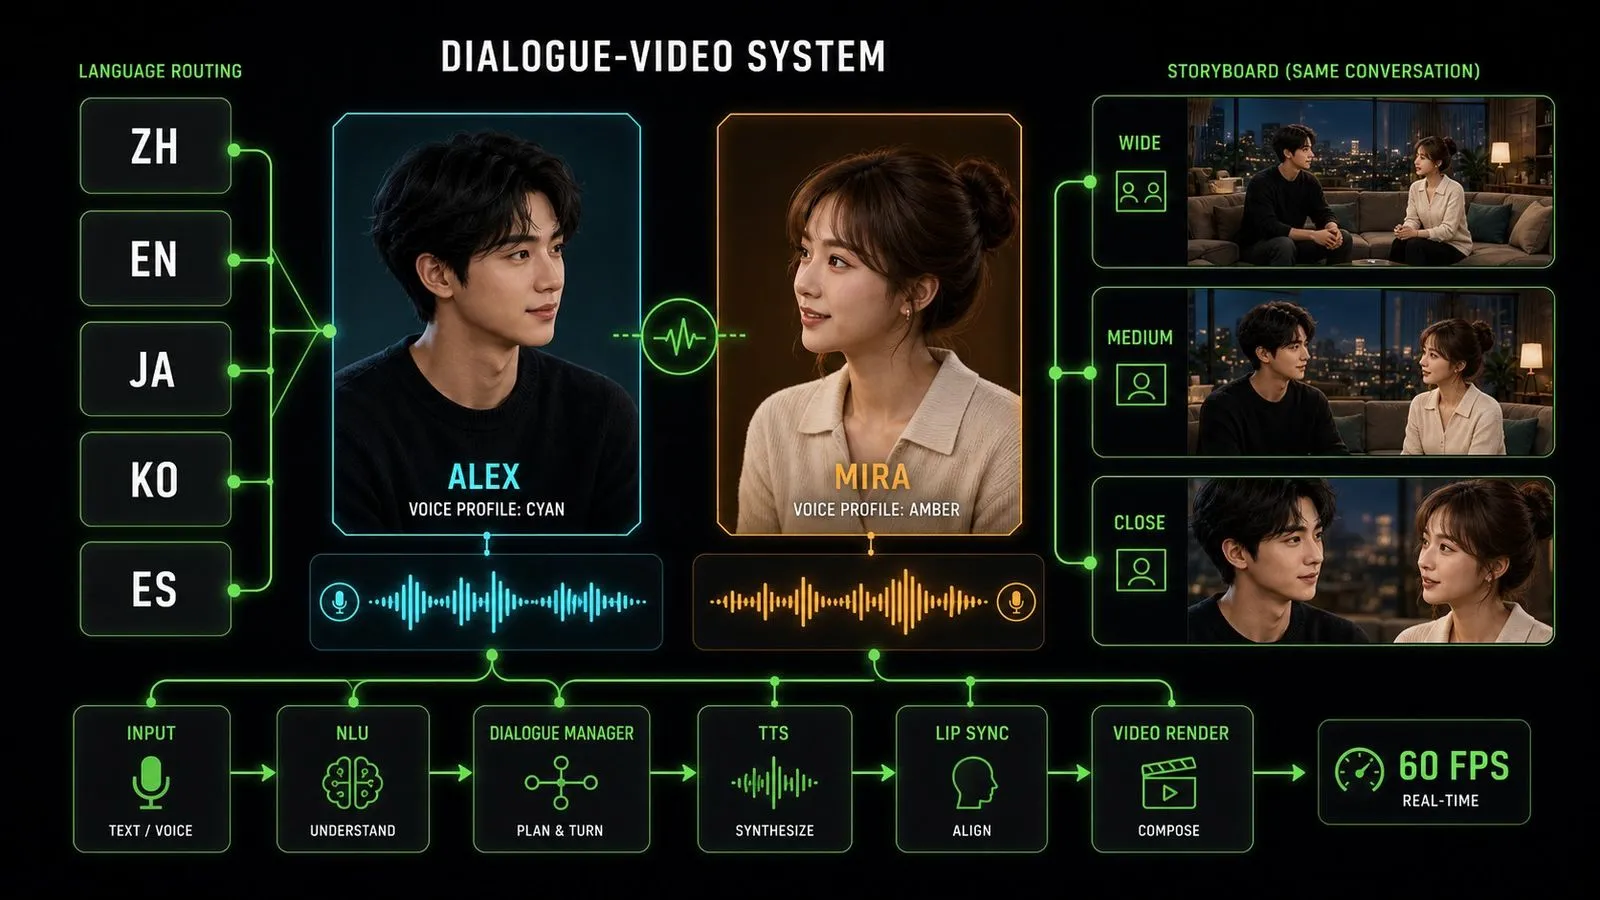
Parole calée sur le mouvement de la bouche plutôt que simplement superposée.
Chinois, anglais, japonais, coréen et espagnol, y compris dans des scènes mêlant plusieurs langues.
Chaque locuteur d’une scène sonne comme une personne différente.
Durée de clip en une seule passe, supérieure au plafond de la génération précédente.
Deux fois la fréquence d’images de la version précédente.
Une séquence de configurations de caméra distinctes planifiée à partir d’un seul prompt.
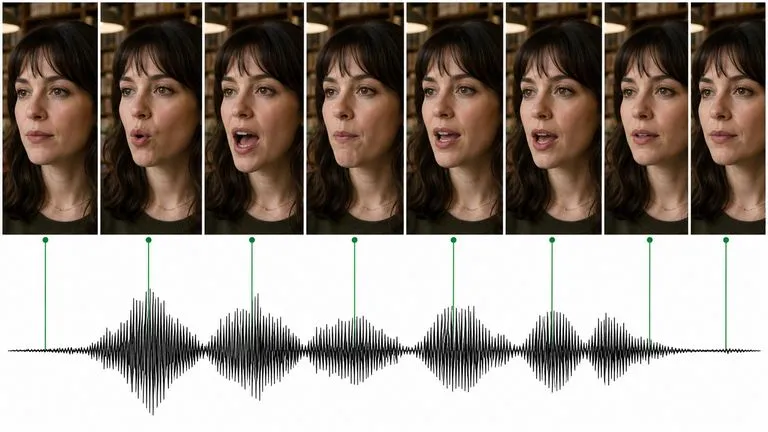
La synchronisation labiale fait toute la différence entre un personnage qui parle et un personnage qui semble mâcher. Kling 3.0 cale le débit sur le mouvement visible de la bouche, ce qui rend les dialogues exploitables, et non simplement présents.
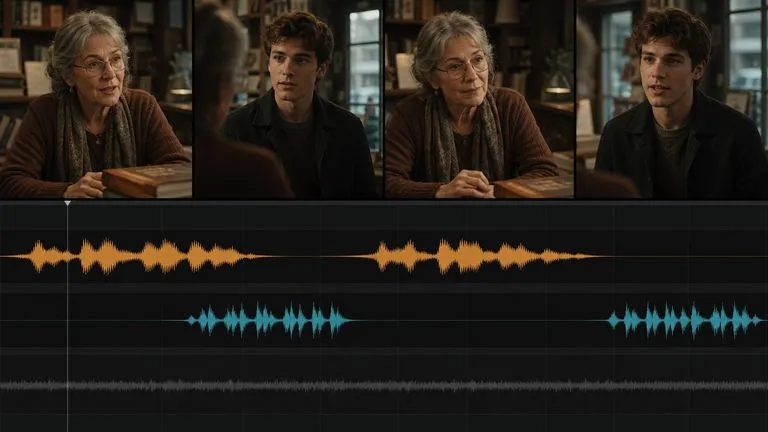
Dans une scène à deux personnages, le fait que les deux personnes aient la même voix sonne immédiatement faux. Des voix distinctes pour chaque personnage suppriment l’indice le plus évident dans les scènes de dialogue générées.
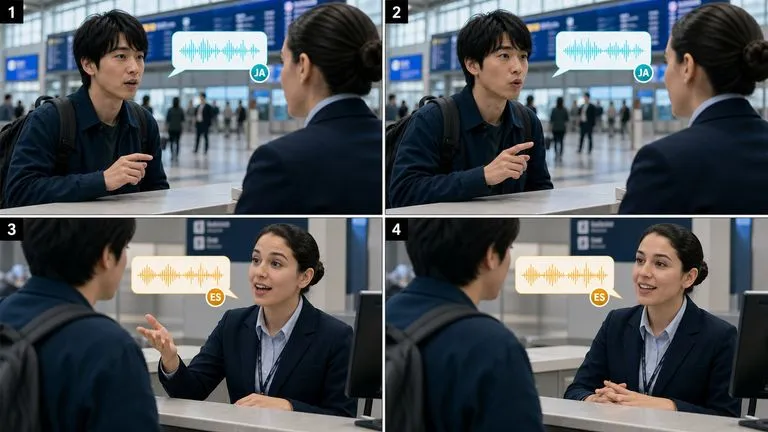
Cinq langues sont prises en charge, et une scène peut contenir des personnages parlant des langues différentes — ce qui est réellement inhabituel et directement utile pour les campagnes déployées sur plusieurs marchés.
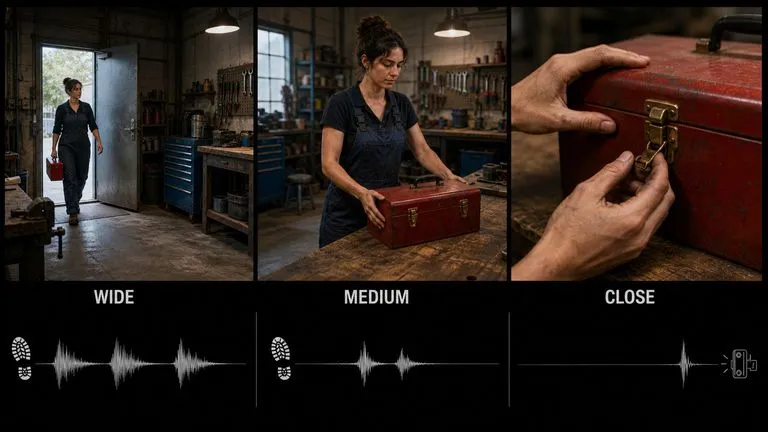
Plutôt que de générer trois plans puis de les monter ensemble, le mode multi-plans planifie la séquence à partir d’un seul prompt, de sorte que les configurations se répondent par conception.
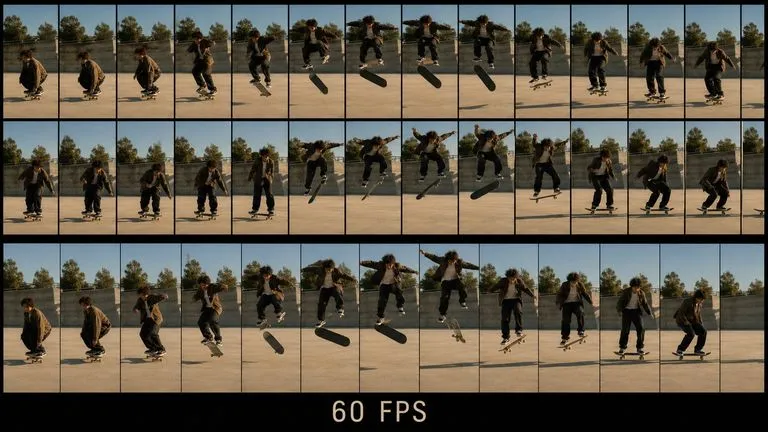
Deux fois la fréquence d’images de la génération précédente, ce qui se voit surtout dans les mouvements rapides et les mouvements de caméra, là où le 30fps commence à saccader.
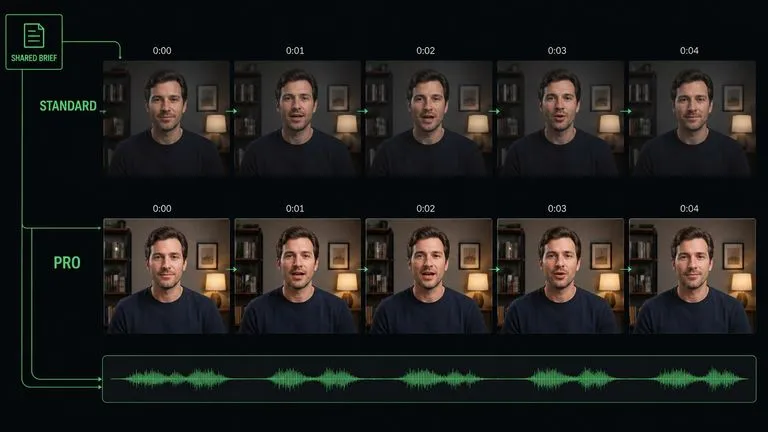
Standard et Pro acceptent les mêmes entrées et les mêmes prompts, si bien que passer de l’itération à la livraison se fait en un clic, sans réécriture.
Le travail sur les dialogues pose un problème de rythme que la vidéo muette n’a pas. Une réplique qui passe bien sur la page prend quatre secondes à prononcer, et vous ne le découvrez qu’après la génération. Virse garde le script à côté du rendu. Le dialogue écrit, les images sur lesquelles il se joue et chaque prise se trouvent sur une même toile, si bien qu’ajuster une réplique et relancer la génération devient une modification sur place plutôt qu’une recherche dans les fichiers.
Placez le dialogue écrit à côté du clip généré afin que les problèmes de timing puissent être rattachés à la réplique qui les a provoqués.
Construisez la composition d’ouverture avec un modèle d’image sur le même canevas et transmettez-la directement à Kling 3.0.
Passez de Kling 3.0 à plus de 30 autres modèles d’image et de vidéo sans quitter le canevas ni réécrire le brief.
Générez la même scène dans la langue de chaque marché et alignez les prises côte à côte.
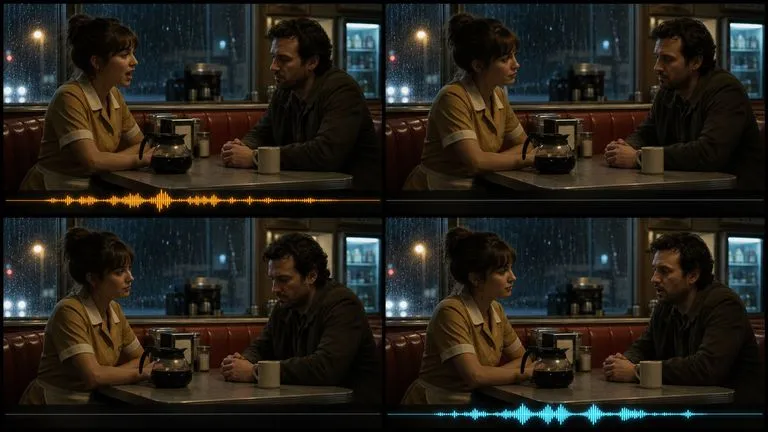
De courts échanges où la parole doit tomber juste avec la bouche et correspondre à l’interprétation.
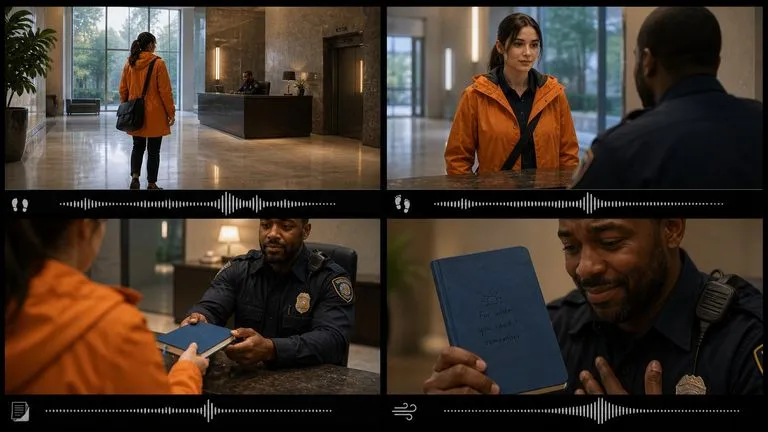
Des séquences multi-plans planifiées comme une séquence plutôt qu’assemblées à partir de clips sans rapport.
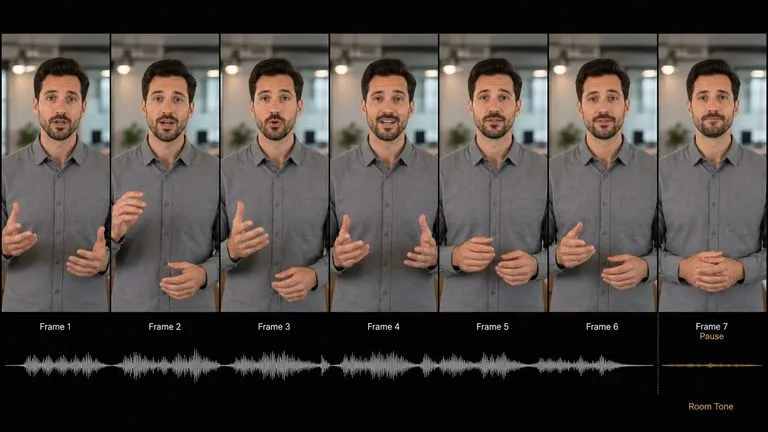
Une personne parlant face caméra, dans celle des langues prises en charge dont un marché a besoin.
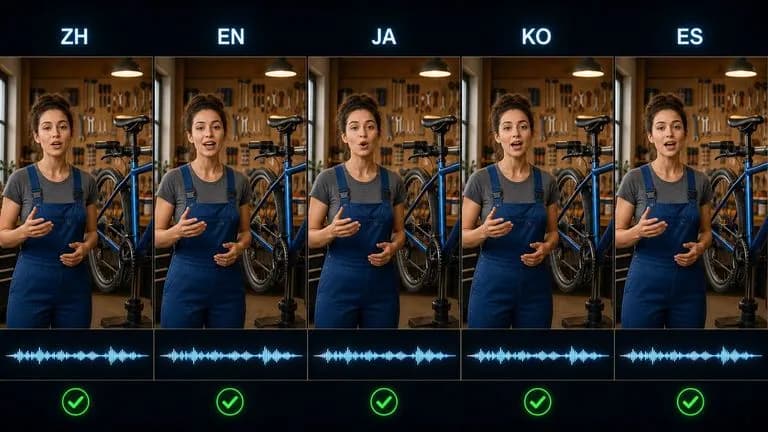
La même scène retournée pour chaque langue sans la reconcevoir.
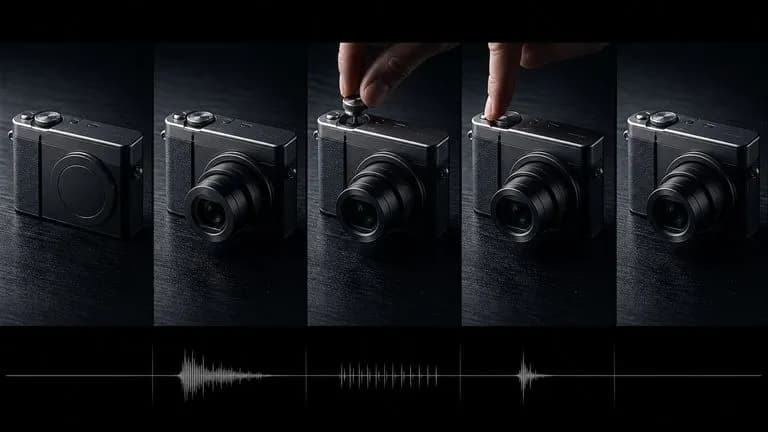
Des révélations et des démonstrations où les effets et l’ambiance sont générés avec l’image.
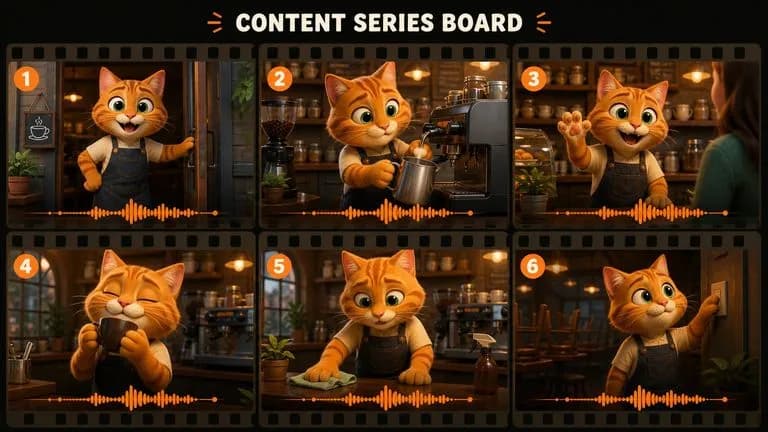
Des personnages récurrents qui prononcent de courtes répliques sur toute une série de posts.
Standard pendant que vous mettez au point la scène, Pro pour la version qui sera livrée.
Importez l’image d’ouverture, l’image de clôture, ou les deux. Fixer les deux extrémités donne le résultat le plus prévisible.
Mettez le dialogue réel entre guillemets et indiquez qui le prononce.
Regardez une première fois pour le rythme avant d’examiner la qualité de l’image. Les problèmes de rythme sont des problèmes de durée.
Un prompt Kling 3.0 utile comprend généralement cinq éléments :
Au lieu d’écrire
Un libraire parlant à un client, cinématographique, dialogue naturel.
Écrivez
Ouverture sur une femme d'une cinquantaine d'années derrière le comptoir d'une librairie, de profil par rapport à la caméra, triant des reçus. Elle lève les yeux et dit : 'Nous fermons dans dix minutes', puis retourne aux reçus. Plan moyen statique depuis la position du client, aucun mouvement. Ambiance intérieure calme, manipulation de papier, bruit de rue lointain à travers la vitre, pas de musique. Terminer avec sa tête de nouveau baissée.
Deux personnes à une petite table de café, vues de côté dans un plan moyen fixe. L’homme dit : "You didn't tell her." La femme attend, puis répond : "I didn't have to." Chaque voix est distincte, le débit est posé, avec un temps de silence entre les répliques. Ambiance de café avec des tasses et des conversations à voix basse, pas de musique. Terminer sur la femme qui détourne le regard.
Une séquence en trois plans dans un atelier, conçue comme une scène continue. Plan un : large, une femme entrant par une porte. Plan deux : moyen, elle pose une boîte à outils sur l’établi. Plan trois : serré, ses mains ouvrent le loquet. Éclairage zénithal cohérent et même personnage tout au long de la scène. Ambiance d’atelier, bruits de pas et déclic du loquet dans le dernier plan. Pas de dialogue, pas de musique.
Un homme en chemise grise unie se tenant devant un arrière-plan de bureau en flou artistique, cadré à mi-corps, face caméra. Il dit : "Trois choses ont changé ce trimestre, et une seule était prévue." Caméra statique, aucun mouvement. Éclairage principal doux et uniforme venant de l'avant gauche. Ambiance sonore calme de la pièce, pas de musique, pas de voix en arrière-plan. Terminer par une pause, bouche fermée.
| Critère | Kling 3.0 Standard | Kling 3.0 Pro |
|---|---|---|
| Positionné pour | Itération rentable | Sortie de qualité finale |
| Entrées | Identique à Pro | Identique à Standard |
| Prise en charge du dialogue | Oui | Oui |
| Mode storyboard | Oui | Oui |
| Audio | Facultatif, facturé séparément | Facultatif, facturé séparément |
| Utilisation typique | Calage du timing et du jeu | La prise qui sera livrée |
Un clip de trois secondes contient environ une courte phrase à un rythme naturel. Un paragraphe oblige le modèle à se précipiter ou à le tronquer.
Nommez-les comme trois couches. Les regrouper dans une seule phrase produit un mélange confus.
Une pause marquée avant une réplique est un choix dirigeable, et elle se lit généralement mieux qu’un son continu.
Décrire trois plans dans l’ordre vaut mieux que les compresser en une seule prise continue que le modèle doit interpréter.
Prepare reference images and visual directions for your next video.
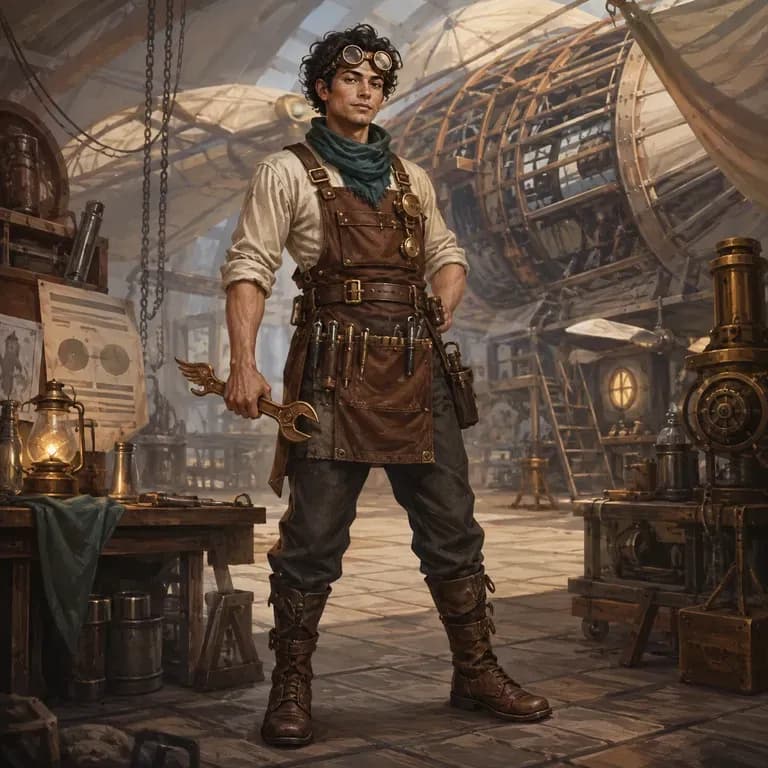
La plupart des prompts de personnages se lisent bien pour une personne, mais s’effondrent face à un modèle d’image, car l’identité, l’univers et le style visuel sont dispersés dans trois phrases différentes au lieu d’être réunis dans une seule qu’il peut analyser. Décrivez qui ils sont, générez une version structurée et testez-la avec un rendu réel directement sur la même toile. Les crédits gratuits couvrent la première série.
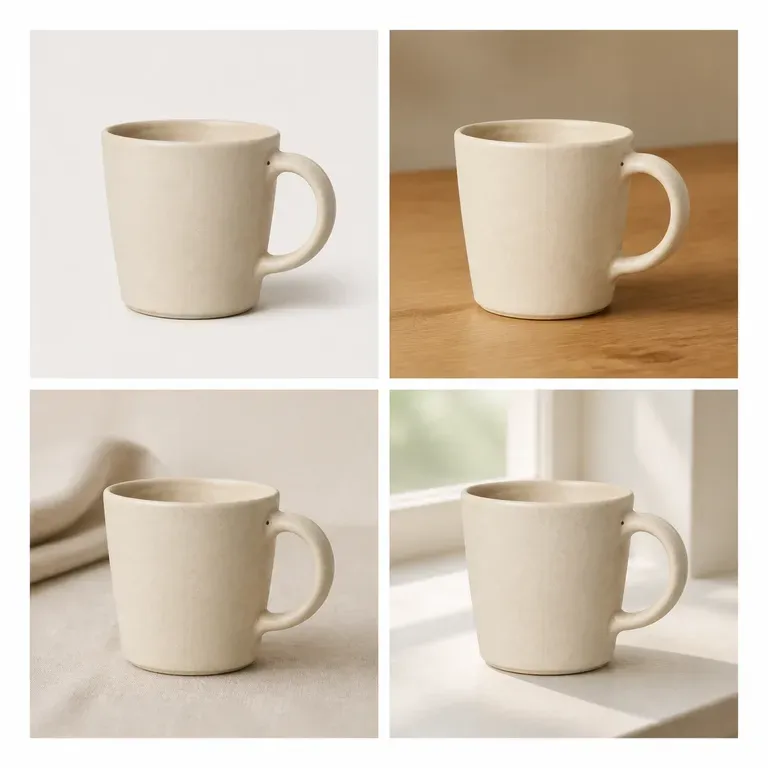
Une variation qui modifie discrètement le produit n’est pas une variation, c’est un produit différent. Importez une image, indiquez si c’est la scène, la couleur ou l’angle qui doit changer, et récupérez une série où tout le reste reste immobile. Les crédits gratuits suffisent pour vérifier si le sujet survit réellement à la série.
La plupart des prompts de design échouent sur les détails ingrats : mauvais ratio d’image, couleur de marque manquante, aucune mention du texte qui doit tenir à tel ou tel endroit. Indiquez l’objectif, l’audience, le format et les contraintes, et cet outil rédige un prompt structuré pour qu’un modèle d’image puisse réellement les prendre tous en compte, en commençant avec des crédits Virse gratuits.
MiniMax's Hailuo 03 model produces silent 2K video, driven either by a first and last frame or by a set of reference images.
Générez des vidéos cinématographiques de 30 secondes avec Seedance 2.5, avec audio synchronisé, références multimodales et contrôle créatif précis.
Veo 3.1 de Google DeepMind génère de courts clips avec un son synchronisé à 48 kHz et les prolonge en séquences plus longues en réutilisant les images finales.
Écrivez la réplique, nommez la voix, et laissez le modèle gérer la bouche, le timing et la pièce où elle est prononcée.