
Audio y vídeo conjuntos
Sonido generado junto con la imagen, en lugar de añadirse después.
Seedance 2.0 de ByteDance produce imagen y sonido en una sola pasada, a partir de un primer y último fotograma o de imágenes de referencia, en tamaños que van de 480P a 4K nativo.
Abre esta página en un navegador de escritorio para empezar a crear.
Seedance 2.0 es el modelo de vídeo de ByteDance, y su característica definitoria es que el audio no es una fase separada.
La mayoría del vídeo generado llega sin sonido y se musicaliza después, por eso gran parte de él se percibe como metraje con música colocada por encima. Seedance 2.0 genera audio y vídeo de forma conjunta, de modo que el ambiente, los sonidos del movimiento y el ritmo se sincronizan con lo que realmente ocurre en pantalla, en lugar de ajustarse aproximadamente más tarde. Virse ofrece el modelo en cuatro entradas, separando la generación basada en fotogramas de la generación basada en referencias y ofreciendo una variante Fast de cada una.
Usa Seedance 2.0 cuando el clip tenga que sonar como el lugar que representa. Crea piezas publicitarias, movimiento de producto, secuencias animadas, series protagonizadas por personajes y vídeos para redes sociales en los que el audio forme parte de la toma, en lugar de ser una decisión que pospones.
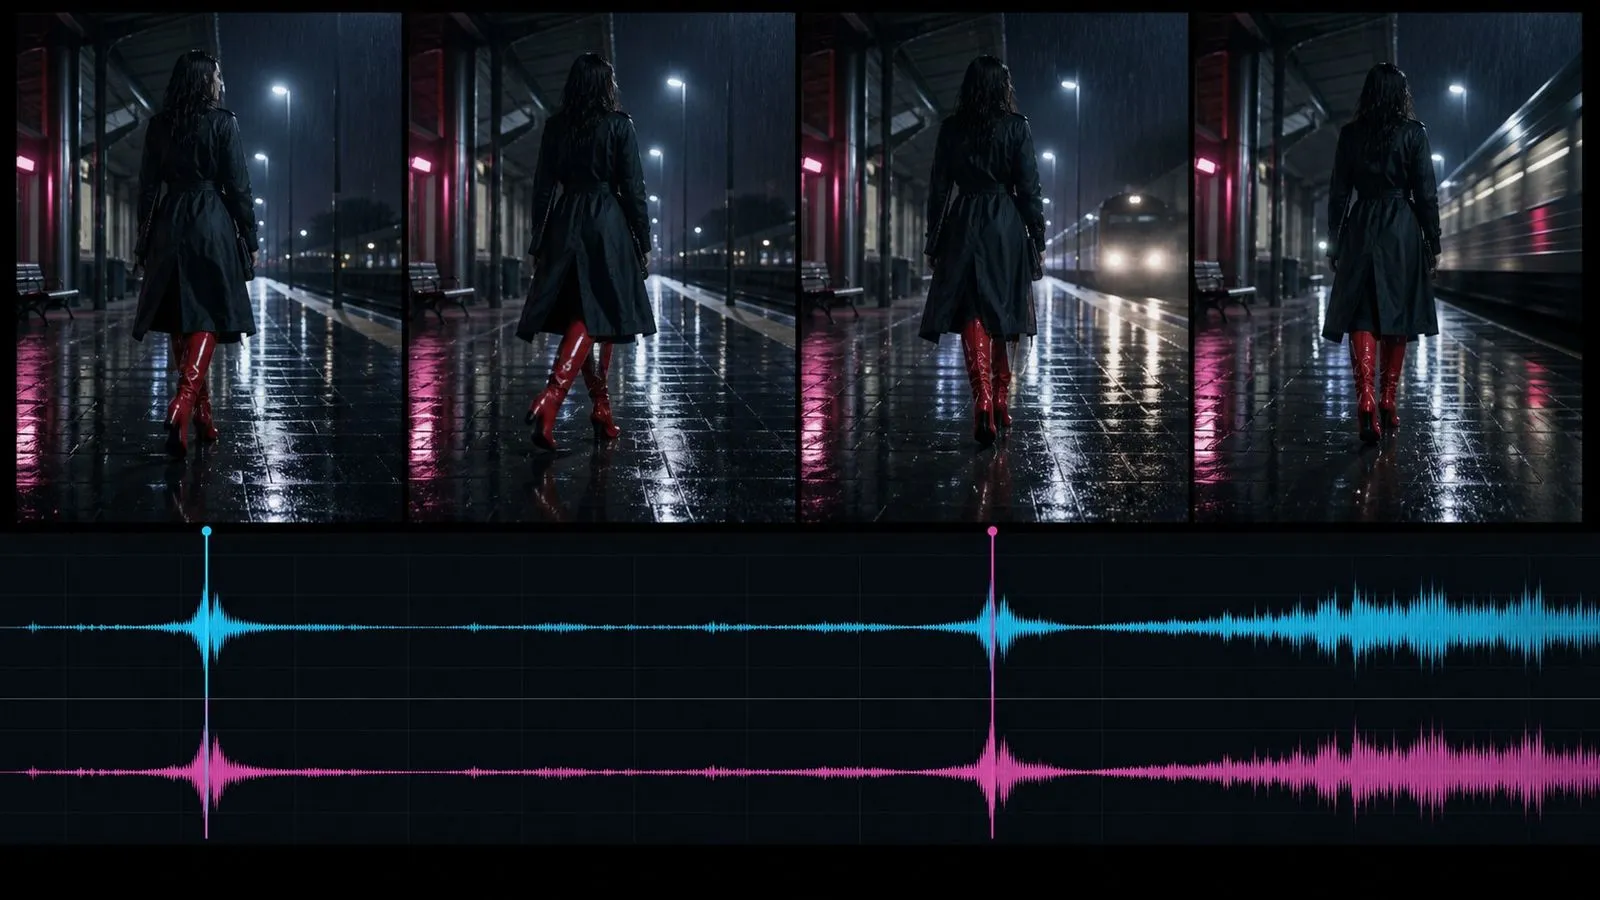
Seedance 2.0 es un modelo de generación de vídeo con IA desarrollado por ByteDance. Genera vídeo con audio sincronizado de doble canal, siguiendo instrucciones escritas sobre los sujetos, la acción, el comportamiento de la cámara, el ritmo y el sonido.
El modelo se basa en tres grandes fortalezas:
Las generaciones duran entre cuatro y quince segundos, con relaciones de aspecto que van de 21:9 a 9:16. Virse enumera cuatro entradas: Seedance 2.0 y Seedance 2.0 Fast toman un primer fotograma, un último fotograma o ambos, mientras que Seedance 2.0 Reference y Seedance 2.0 Fast Reference funcionan, en cambio, a partir del material de referencia proporcionado.
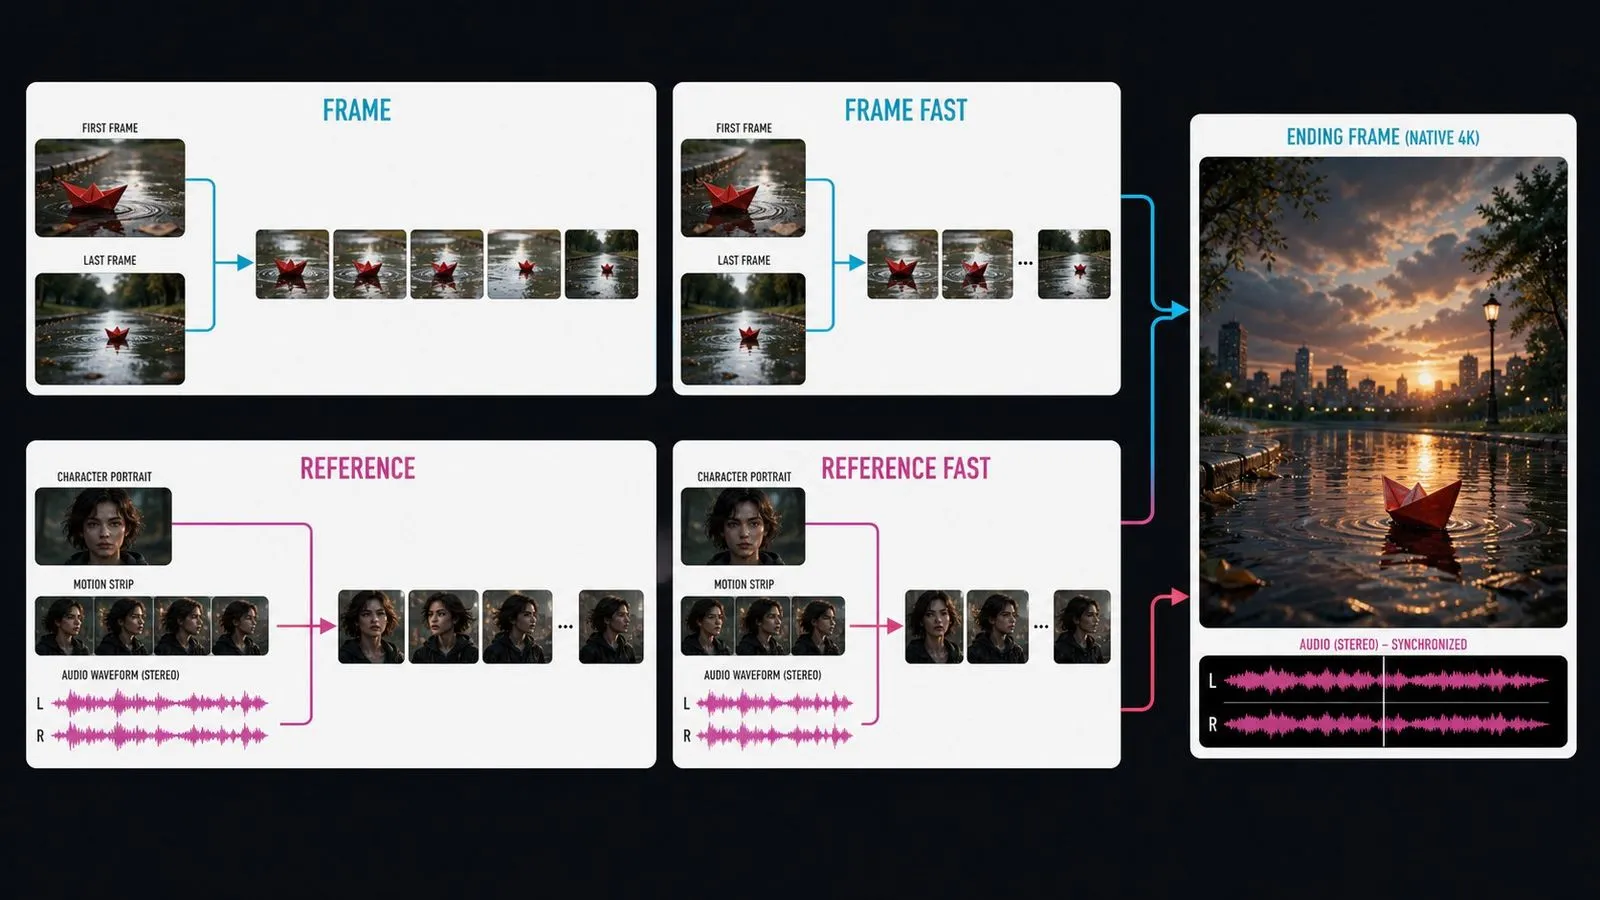
Sonido generado junto con la imagen, en lugar de añadirse después.
Duración de generación en una sola pasada, ampliable continuando desde un resultado anterior.
Salida 4K real en lugar de un reescalado, con 480P, 720P y 1080P por debajo.
Se pueden proporcionar como entrada imágenes, clips de vídeo y audio.
Flujos basados en fotogramas y basados en referencias, cada uno con una variante rápida.
De 21:9 a 9:16 a partir del mismo briefing escrito.
Como el sonido se genera junto con la imagen, una pisada cae cuando el pie pisa. Esa sincronización es difícil de conseguir sonorizando un clip silencioso a posteriori y es la razón principal para elegir un modelo conjunto.
La mayoría de los modelos de vídeo aceptan imágenes. Este también toma clips de vídeo y audio como material de referencia, de modo que el carácter del movimiento y la textura sonora pueden mostrarse en lugar de describirse.
Las cuatro opciones se dividen claramente. Proporciona fotogramas cuando sabes con qué abre y cierra el plano; proporciona referencias cuando un sujeto debe seguir siendo reconocible y describirlo es más difícil que mostrarlo.
480P existe para que probar el timing y el movimiento no consuma el presupuesto del montaje final. El briefing no cambia cuando subes de resolución.
Seedance 2.0 Fast y Fast Reference cubren los tamaños inferiores a un coste reducido, que es donde deben estar las rondas exploratorias.
El modelo gestiona el movimiento de dibujos animados 2D, las secuencias animadas en 3D y los tratamientos ilustrados con la misma facilidad que el metraje de estilo imagen real.
El vídeo basado en referencias necesita que sus referencias existan primero, y rara vez llegan como un conjunto ordenado. Un personaje procede de un lugar, una toma de producto de otro y una referencia de movimiento de un tercero. Virse reúne ese material en el mismo espacio donde se crea el vídeo. Las imágenes fijas generadas por cualquier modelo de imagen en el lienzo pueden pasar directamente a Seedance 2.0 como referencias o fotogramas, sin tener que exportar y volver a subir entre medias.
Genera imágenes estáticas de personajes y productos con un modelo de imagen y, después, dirige Seedance 2.0 a ellas directamente.
Fija el timing y el movimiento a 480P y, después, vuelve a ejecutar el mismo briefing a 1080P o 4K.
Pasa de Seedance 2.0 a más de 30 modelos de imagen y vídeo, y viceversa, sin salir del lienzo ni reescribir el briefing.
Reutiliza el mismo conjunto de referencias en todos los clips de una secuencia para que toda la ejecución se mantenga coherente.
Secuencias breves de marca en las que la base de audio se genera con la imagen.
Rotaciones, revelaciones y pasadas de detalle que empiezan y terminan en composiciones definidas.
Secuencias ilustradas y animadas que mantienen un aspecto coherente entre planos.
Una serie de clips en la que un intérprete se mantiene reconocible de un plano a otro.
Cortes verticales y apaisados esbozados a 480P y finalizados a 1080P.
Guiones gráficos convertidos en referencia en movimiento antes de que nada entre en producción.
Basado en fotogramas para composiciones definidas, basado en referencias para la continuidad, Rápido para la exploración.
Sube los fotogramas inicial y final, o el material de referencia, e indica qué aporta cada uno.
Describe qué se mueve, cómo se comporta la cámara y cómo debería sonar el clip.
Lleva el briefing aprobado hasta 1080P o 4K sin cambiar ni una palabra.
Un prompt útil para Seedance 2.0 suele incluir seis elementos:
En lugar de escribir
Un vídeo de producto de un reloj, cinematográfico.
Escribe
Abre con la esfera del reloj mostrada en la Imagen 1, llenando el encuadre bajo una única luz cenital dura. Gira lentamente en sentido horario alrededor de la caja mientras los reflejos recorren el bisel pulido. A mitad de recorrido, retrocede para revelar el reloj completo descansando sobre piedra oscura. Termina con la composición de la Imagen 2. Mantén el movimiento continuo sin cortes. Tono de sala silencioso durante todo el vídeo, con un tono metálico grave cuando la cámara se estabiliza.
Comienza con el frasco de perfume cerrado mostrado en la Imagen 1, centrado sobre un fondo burdeos intenso. Acércate lentamente durante el primer tercio del clip mientras la luz se desplaza sobre el cristal. Levanta el tapón en un único movimiento continuo, manteniendo el frasco inmóvil y la cámara estable. Termina con la composición de la Imagen 2, con el tapón suspendido sobre el frasco. Ambiente tenue de sala y un suave tintineo de cristal en el momento en que se levanta el tapón.
Anima al personaje de la Imagen 1 con el estilo ilustrado de la Imagen 2. El personaje entra caminando desde la izquierda de un claro del bosque pintado a mano, se detiene en el centro y mira hacia arriba mientras la luz se abre paso a través del dosel. Mantén el trazo, la paleta de colores y las proporciones de las referencias en todo momento. Cámara fija. Ambiente de bosque por capas con canto de pájaros, y una ligera frase musical ascendente cuando el personaje mira hacia arriba.
Usa el modelo de la Imagen 1, la chaqueta de la Imagen 2 y la ubicación en la azotea de la Imagen 3. Empieza con un plano medio mientras el modelo se gira hacia la cámara; después, desplaza lentamente la cámara hacia la derecha mientras el horizonte de la ciudad entra en plano detrás. Mantén el rostro, y el corte, el color y la textura de la chaqueta, tal como muestran las referencias. Luz diurna nublada. Viento, tráfico lejano y una base electrónica contenida de fondo.
| Dimensión | Seedance 2.0 | Seedance 2.5 |
|---|---|---|
| Duración del clip | De cuatro a quince segundos | Hasta treinta segundos |
| Entradas de referencia | Imágenes, vídeo y audio | Conjunto de referencias multimodales más amplio |
| Continuidad narrativa | Planos individuales y secuencias cortas | Extensión en varias rondas para narrativas más largas |
| Control de edición | A nivel de prompt en todo el clip | A nivel de marca de tiempo en momentos concretos |
| Entradas en Virse | Cuatro, separando fotogramas de referencias | Una |
| Dónde encaja | Planos definidos en un tamaño elegido | Narrativas estructuradas más largas |
En un modelo conjunto, el silencio sobre el sonido no es neutral: significa que el modelo decide. Nombra la mezcla incluso cuando sea sencilla.
Restringir la composición final elimina la mayor parte de la deriva de un plano que tiene que terminar en un punto concreto.
Nombrar lo que aporta cada imagen, clip o archivo de audio es lo que evita que el modelo los promedie entre sí.
Define el encuadre, el ritmo y el movimiento de cámara en el tamaño más bajo y gasta el presupuesto de entrega una sola vez.
Prepara imágenes de referencia e indicaciones visuales para tu próximo vídeo.
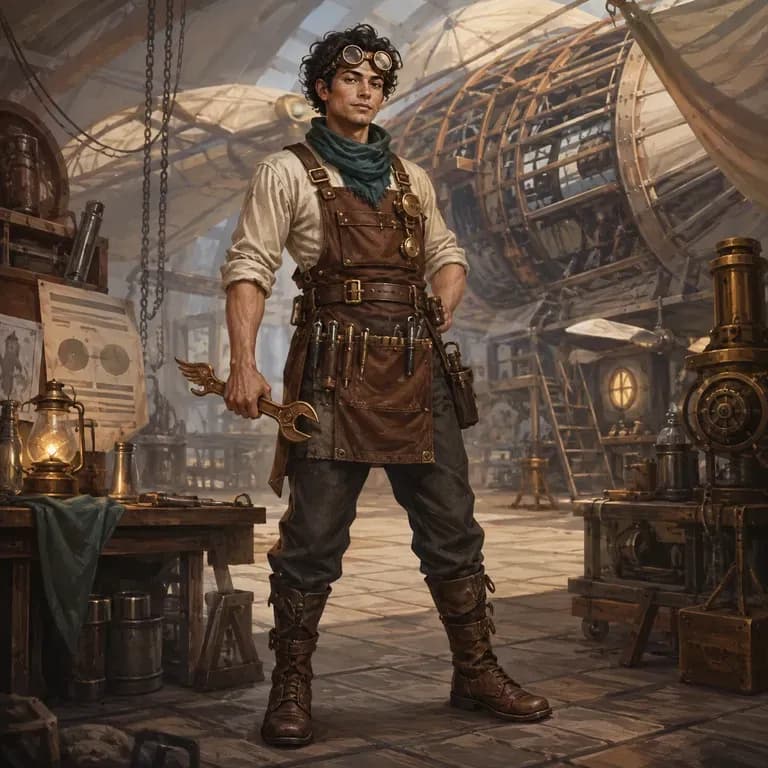
La mayoría de los prompts de personajes se leen bien para una persona y se desmoronan ante un modelo de imagen, porque la identidad, el mundo y el estilo visual están dispersos en tres frases distintas en lugar de estar en una que pueda interpretar. Describe quiénes son, genera una versión estructurada y pruébala con un render real directamente en el mismo lienzo. Los créditos gratuitos cubren la primera ronda.
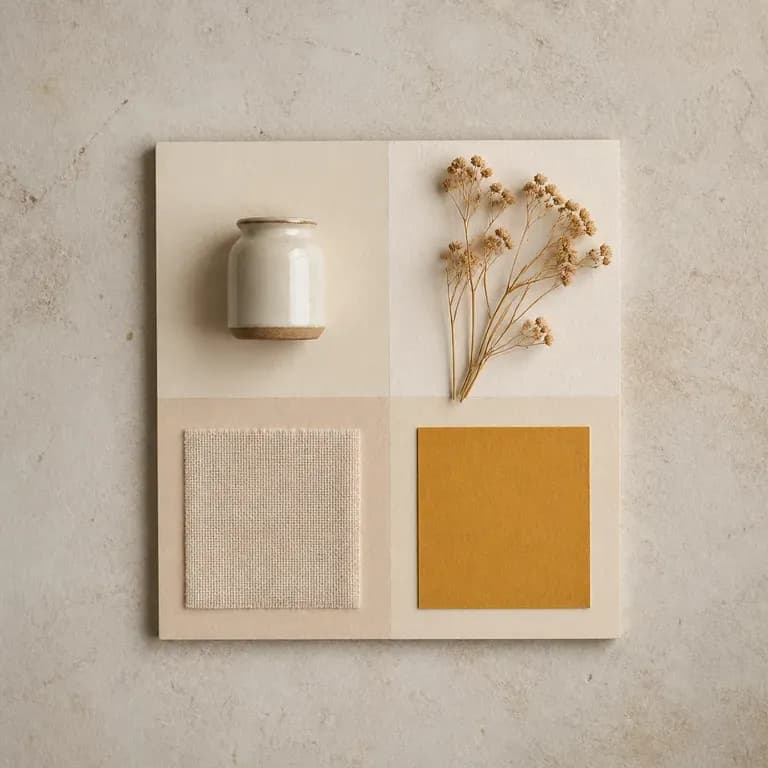
Una versión de un mood es solo una conjetura. Dale una referencia o un tema escrito y recibe varias lecturas distintas de la misma idea, con color, material e imágenes compuestos en un solo tablero, para tener algo ante lo que reaccionar en lugar de una página en blanco. Los créditos gratuitos son suficientes para empezar.
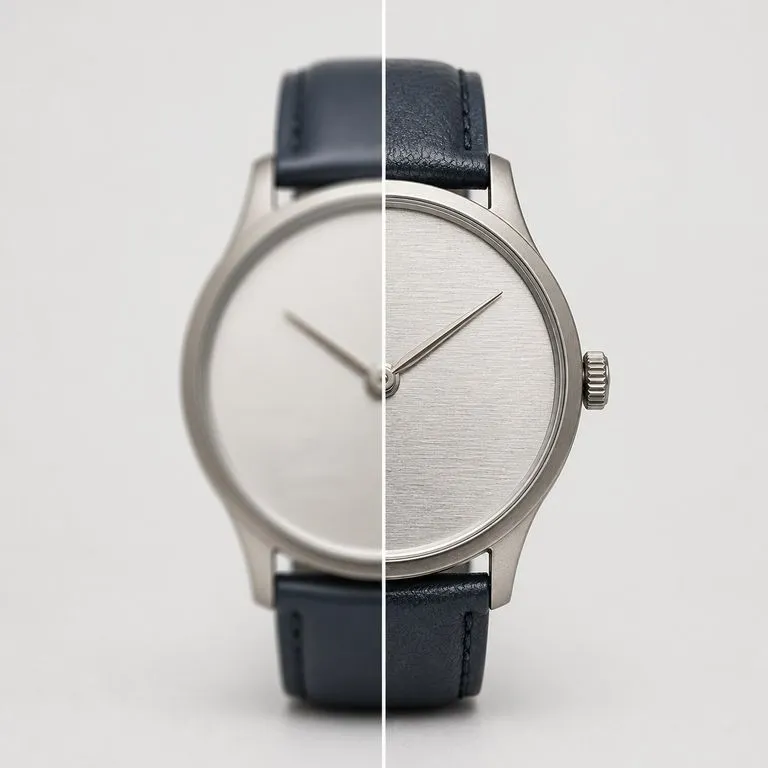
Sube una imagen que no tenga la calidad suficiente para usarla. Detecta qué ha fallado realmente, ya sea desenfoque, ruido, artefactos de compresión o simplemente falta de píxeles, lo repara primero y luego renderiza a la resolución que elijas.
Genera vídeos cinematográficos de 30 segundos con Seedance 2.5, con audio sincronizado, referencias multimodales y un control creativo preciso.
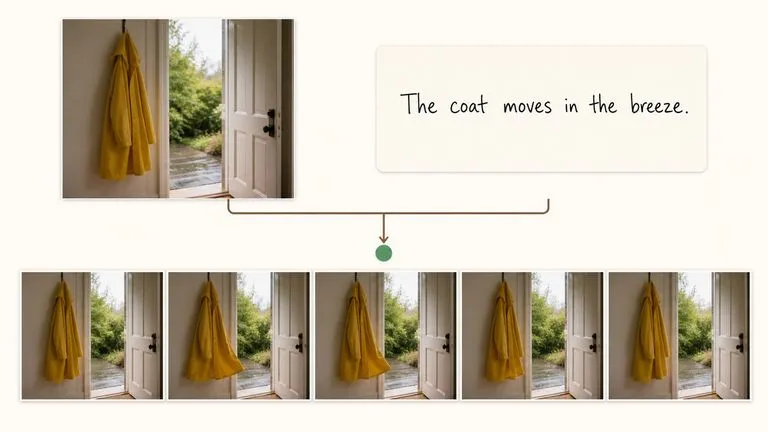
El modelo de vídeo con IA Happy Horse 1.0 necesita una imagen fija y una frase, y genera movimiento a partir del fotograma que ya tienes.
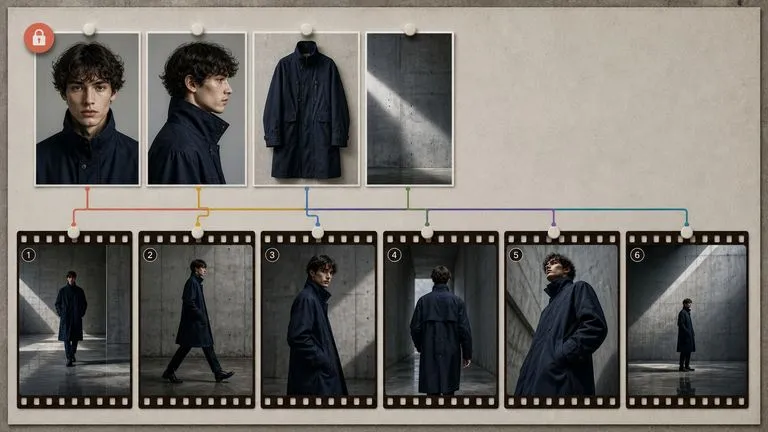
El modelo Hailuo 03 de MiniMax produce vídeo 2K silencioso, impulsado ya sea por un primer y último fotograma o por un conjunto de imágenes de referencia.
Lleva tu fotograma inicial, tus referencias y tus indicaciones de sonido a un único espacio de trabajo, y deja que el modelo gestione el movimiento y la mezcla conjuntamente.