
Fotograma inicial único
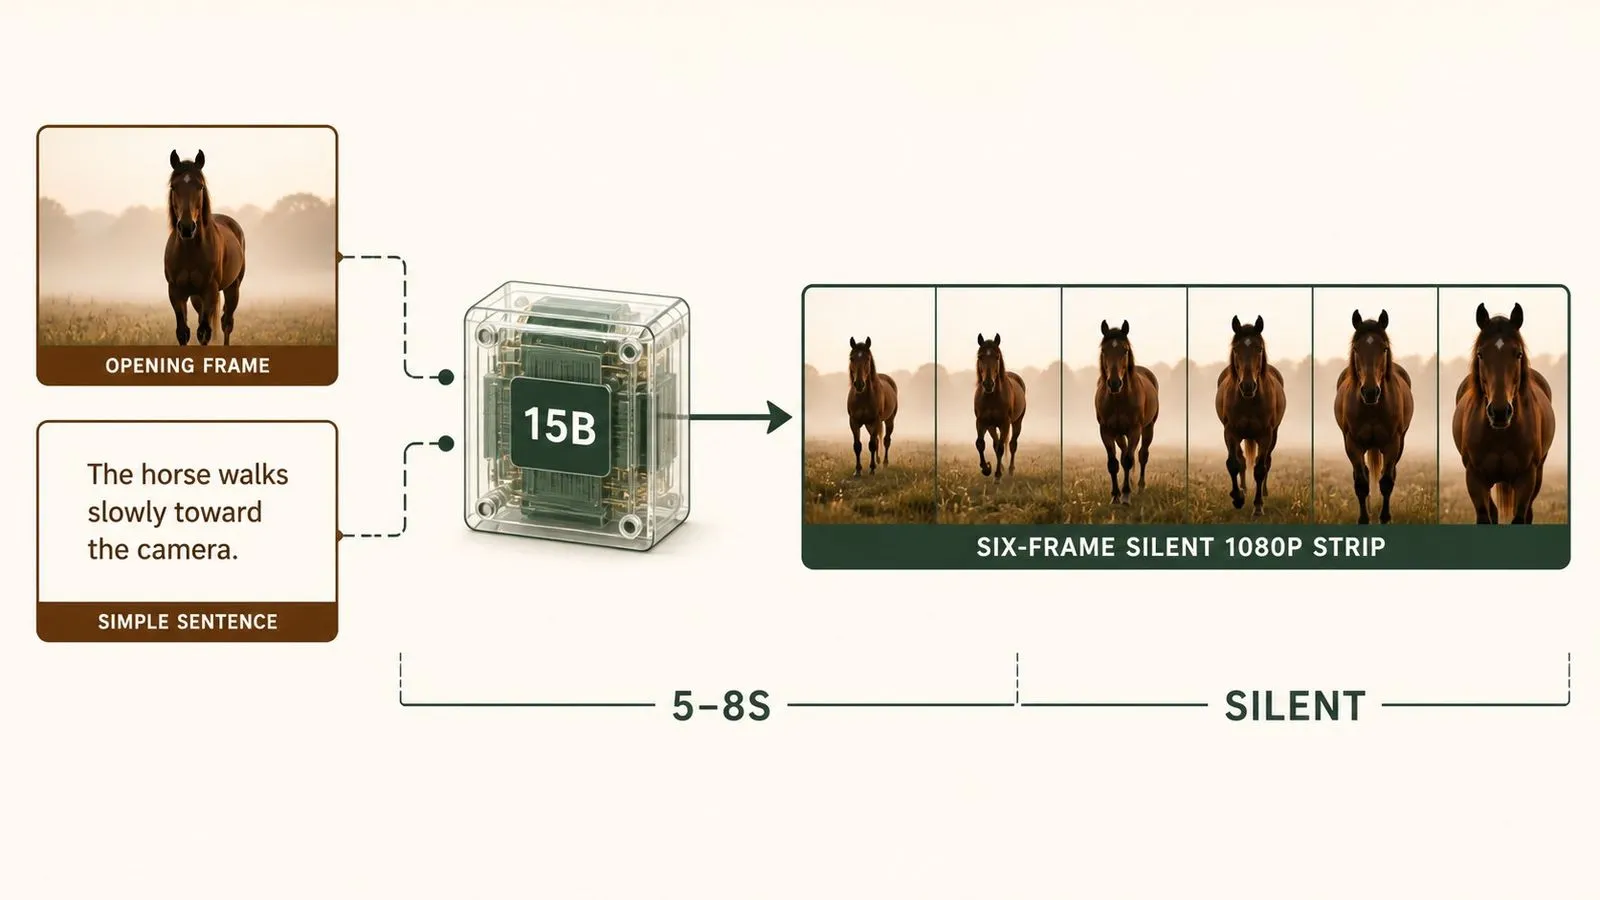
Una imagen es toda la entrada visual.
El modelo de vídeo con IA Happy Horse 1.0 necesita una imagen fija y una frase, y genera movimiento a partir del fotograma que ya tienes.
Abre esta página en un navegador de escritorio para empezar a crear.
El modelo de vídeo de IA Happy Horse pide menos material de entrada que cualquier otro del catálogo de vídeo de Virse, y esa estrechez es la razón para usarlo.
La mayoría de los modelos de vídeo quieren de ti más de lo que tienes: un primer fotograma y un último fotograma, varias imágenes de referencia con funciones definidas, un briefing que cubra el comportamiento de la cámara y el diseño de sonido. Cuando tienes exactamente una imagen y quieres verla moverse, esos modelos te obligan a inventar material que no posees. Este empieza donde realmente estás: un único fotograma inicial y una descripción de lo que ocurre a continuación.
Utiliza el modelo de vídeo de IA Happy Horse cuando el punto de partida ya exista. Anima una fotografía, da vida a una imagen fija generada, prueba si una idea funciona en movimiento y produce clips cortos sin tener que preparar primero un briefing.
Happy Horse 1.0 es un modelo de generación de vídeo de 15.000 millones de parámetros construido sobre un Transformer unificado de flujo único, y el primero en generar imagen y sonido en una única pasada hacia delante en lugar de en etapas separadas. Entró en la clasificación de pruebas ciegas de Artificial Analysis en el número uno en abril de 2026 y se publica como código abierto bajo una licencia comercial.
El modelo se construye en torno a tres grandes fortalezas:
Los clips duran entre cinco y ocho segundos, con relaciones de aspecto que abarcan 16:9, 9:16, 4:3, 21:9 y 1:1. La configuración ofrecida en Virse genera audio con la imagen, impulsada por un único fotograma inicial más una instrucción escrita.
Una imagen es toda la entrada visual.
Un Transformer unificado de flujo único en lugar de un proceso por etapas.
Imagen y sonido generados juntos en el modelo subyacente.
Salida Full HD en lugar de un reescalado.
Duración del clip en una sola pasada.
16:9, 9:16, 4:3, 21:9 y 1:1.
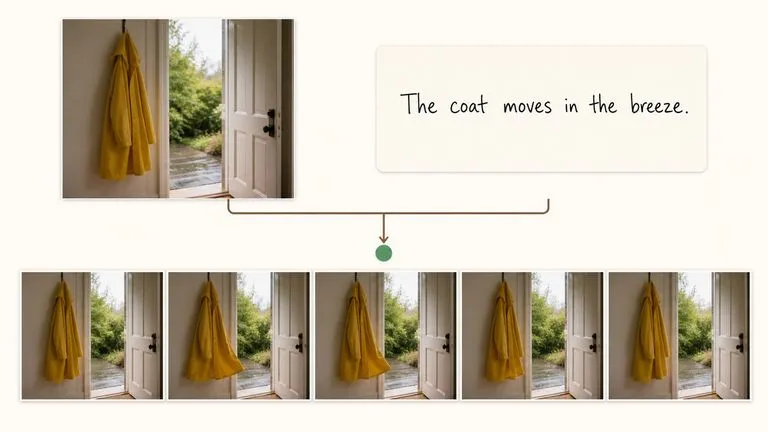
Una imagen y una frase son todo el requisito. No hay que reunir un conjunto de referencias ni diseñar un fotograma de cierre, lo que convierte a esta en la ruta más rápida para pasar de tener una imagen a verla moverse.
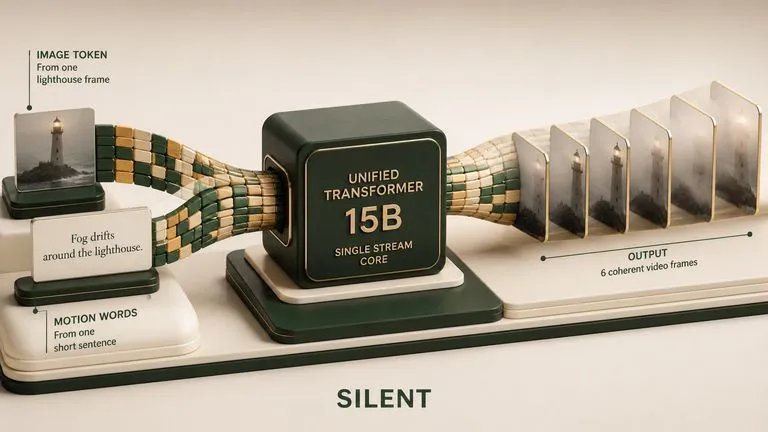
Generar audio y vídeo en una sola pasada directa, en lugar de producir un clip silencioso y evaluarlo después, es lo que el modelo se creó para demostrar, y alcanzó el primer puesto de una clasificación de pruebas a ciegas haciéndolo.
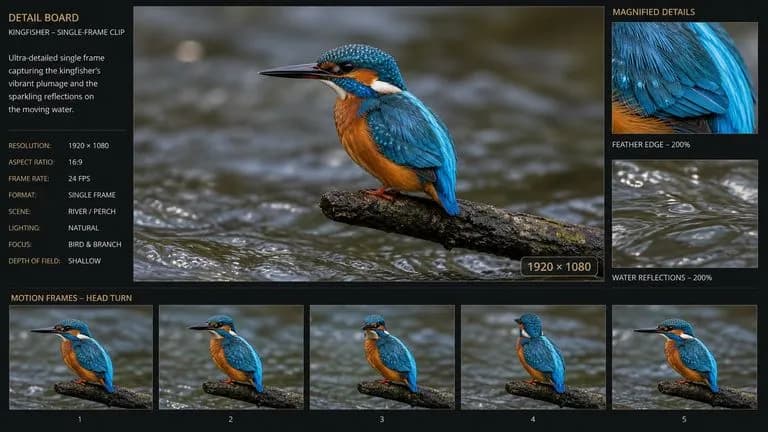
Full HD sale directamente del modelo. Para un modelo impulsado por un único fotograma, es un techo más alto de lo que sugiere el requisito de entrada.
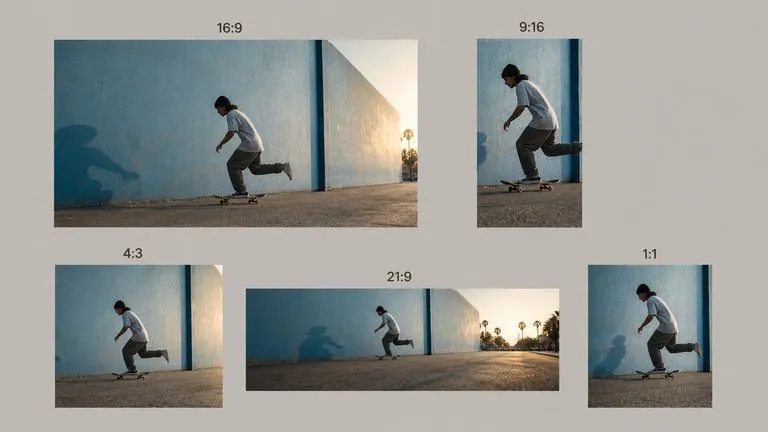
Horizontal, vertical, cuadrado y ultraancho a partir del mismo briefing, lo que importa cuando un clip tiene que aparecer en varios lugares.
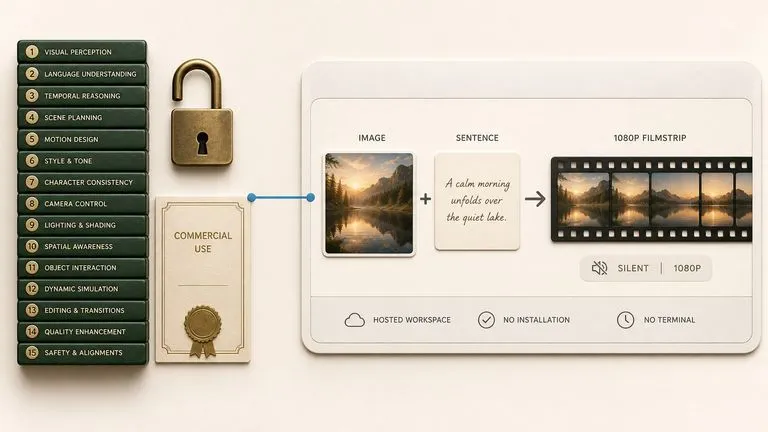
El modelo se publica de forma abierta con uso comercial permitido, aunque en Virse se ejecuta como un servicio alojado sin nada que instalar.
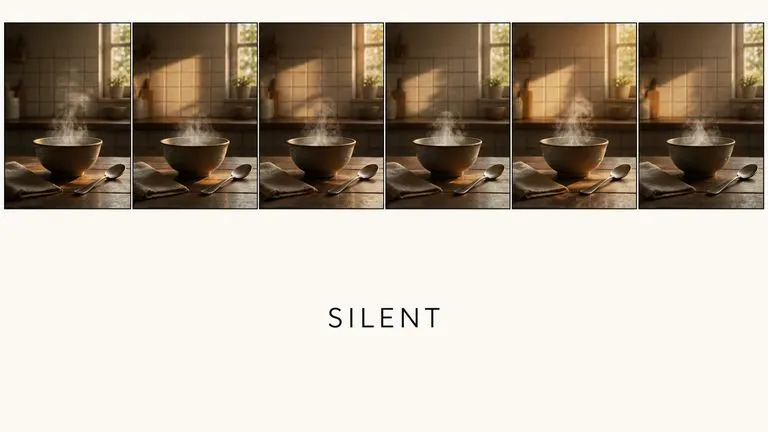
El sonido se genera junto con la imagen en la misma pasada, y no hay ningún interruptor para desactivarlo.
Un modelo de un solo fotograma cambia lo que se considera digno de probar. Cuando la entrada es una imagen que ya tienes, la cuestión deja de ser si preparar un briefing y pasa a ser simplemente si sientes curiosidad. Virse hace que actuar en función de esa curiosidad sea barato. Cualquier imagen fija en el lienzo —generada por un modelo de imagen o arrastrada desde otro lugar— puede enviarse al modelo de vídeo con IA Happy Horse sin salir del espacio de trabajo.
Toma cualquier imagen fija que ya esté en el espacio de trabajo y ponla en movimiento sin exportarla primero.
Averigua si una composición funciona en movimiento antes de invertir en un conjunto de referencias para un modelo más pesado.
Cambia entre el modelo de vídeo de IA Happy Horse y más de 30 otros modelos de imagen y vídeo sin salir del lienzo ni reescribir el briefing.
Cuando una toma tiene que llegar a una composición final concreta, entrega el mismo fotograma a un modelo que acepte ambos extremos.
Movimiento añadido a una toma de producto, una ubicación o un retrato que ya tienes.
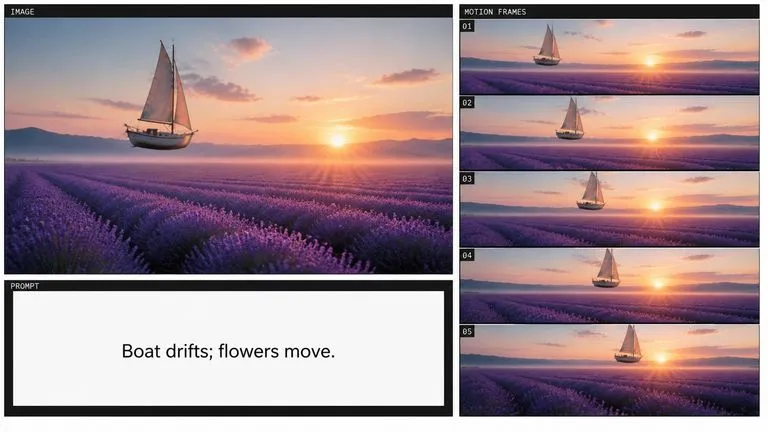
Cualquier imagen del lienzo convertida en un clip breve en movimiento.
Vídeo corto vertical o cuadrado producido a partir de un único recurso existente.
Comprobaciones rápidas de si una imagen fija se lee como movimiento antes de seguir adelante.
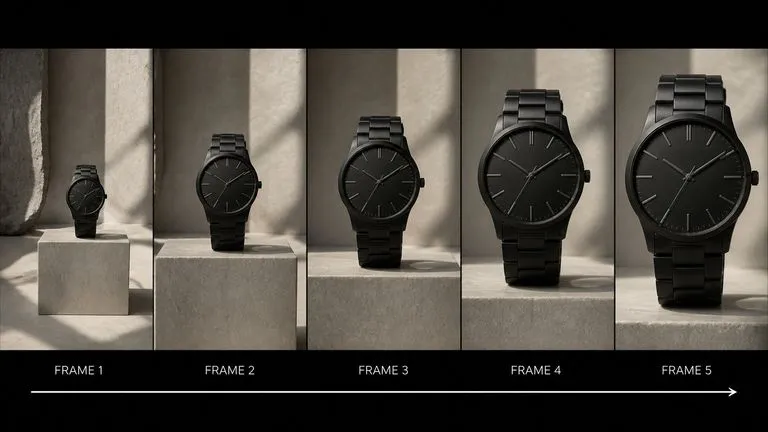
Un lento acercamiento o desplazamiento que empieza desde la toma de producto que ya tienes.
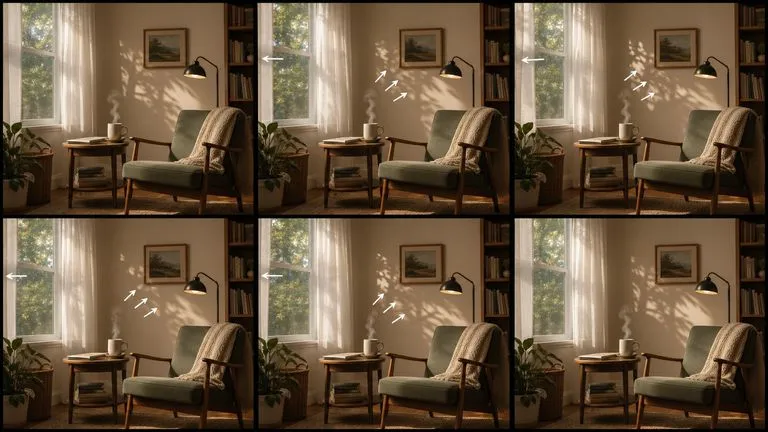
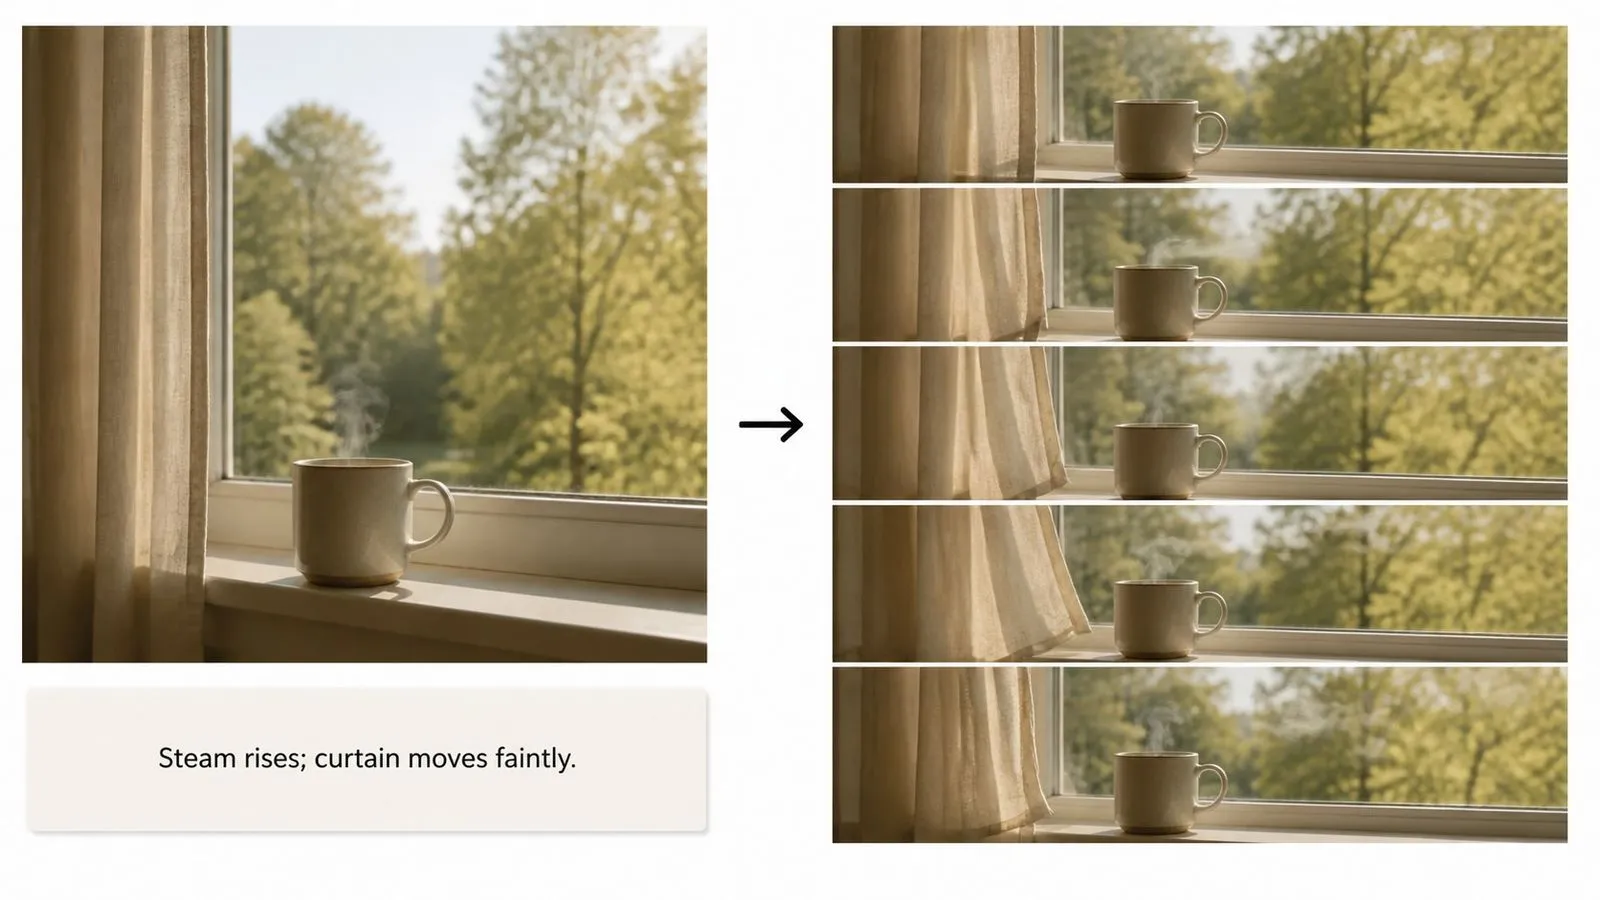
Movimiento ambiental — vapor, viento, cambios de luz — añadido a una escena estática.
Sube una imagen o arrastra una desde otra parte del lienzo.
Di qué se mueve y cómo se comporta la cámara. Una acción se entiende mejor que tres.
Evalúa el ritmo antes que la imagen. Los problemas de ritmo vienen del briefing.
Cuando el movimiento no sea correcto, reescribe la cláusula de movimiento en lugar de sustituir la imagen de entrada.
Un prompt útil de vídeo con IA de Happy Horse suele incluir tres elementos:
En lugar de escribir
Haz que esta imagen cobre vida, con movimiento cinematográfico, hermosa.
Escribe
La cámara avanza lenta y firmemente hacia el centro del encuadre. El vapor se eleva de la taza en una fina corriente continua. Nada más se mueve y no hay cortes.
La cámara permanece completamente quieta. El vapor se eleva de la taza en un chorro fino y continuo, desplazándose ligeramente hacia la derecha. La cortina en el borde del encuadre se mueve levemente. Nada más en la escena cambia. Sin cortes, sin movimiento de cámara, sin cambios de luz.
La cámara avanza lenta y uniformemente hacia el producto en el centro del encuadre, deteniéndose antes de que ocupe toda la toma. El producto en sí no se mueve ni gira. La luz permanece fija, por lo que el brillo se desplaza ligeramente por la superficie a medida que el encuadre se cierra. Sin cortes.
La cámara se desplaza lentamente hacia la izquierda a una velocidad constante. La hierba en primer plano se mueve con un viento suave. La sombra de una nube pasa gradualmente por el plano medio. La línea del horizonte se mantiene nivelada en todo momento y nada entra en el encuadre. Termina con la composición desplazada un cuarto del ancho del encuadre hacia la izquierda.
| Dimensión | Happy Horse AI Video | Seedance 2.0 |
|---|---|---|
| Entrada visual | Un único fotograma inicial | Fotogramas o un conjunto de referencia |
| Control del punto final | Solo fotograma inicial | Primer y último fotograma |
| Salida en Virse | Sin sonido | Audio generado con la imagen |
| Duración del clip | De cinco a ocho segundos | De cuatro a quince segundos |
| Configuración necesaria | Una imagen y una frase | Un briefing que cubra acción y sonido |
| Elígelo cuando | Tienes una imagen y una pregunta | La toma tiene que acabar en un punto concreto |
El fotograma ya establece el aspecto de las cosas. Dedica el prompt a lo que cambia.
Entre cinco y ocho segundos sostienen una sola acción. Los briefings que apilan varias las producen todas a la vez, y mal.
Nombrar los elementos estáticos es lo que impide que el modelo anime toda la escena.
El sonido se renderiza en cada generación, así que merece la pena escribir en el prompt indicaciones de ambiente, efectos y diálogo.
Prepara imágenes de referencia e indicaciones visuales para tu próximo vídeo.
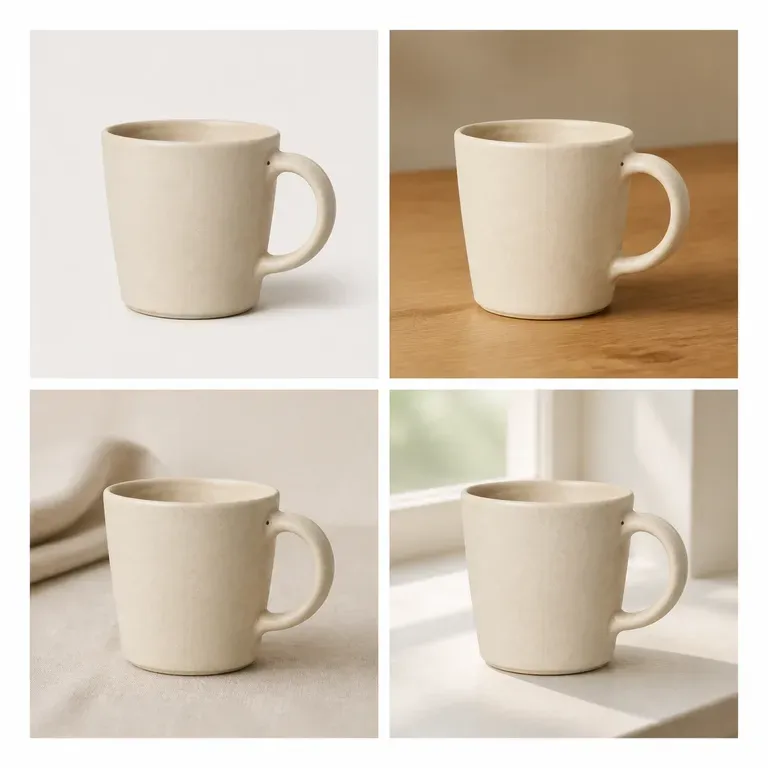
Una variación que cambia discretamente el producto no es una variación, es un producto diferente. Sube una imagen, indica si debe cambiar la escena, el color o el ángulo, y recibe un lote en el que todo lo demás permanece igual. Los créditos gratuitos son suficientes para comprobar si el sujeto realmente se mantiene en todo el lote.
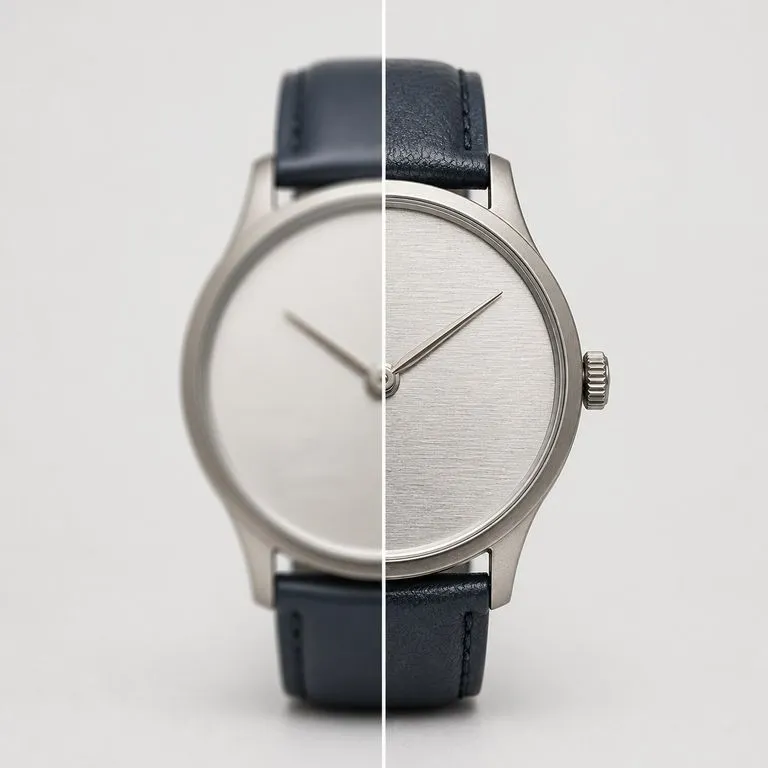
Sube una imagen que no tenga la calidad suficiente para usarla. Detecta qué ha fallado realmente, ya sea desenfoque, ruido, artefactos de compresión o simplemente falta de píxeles, lo repara primero y luego renderiza a la resolución que elijas.
La mayoría de los prompts de personajes se leen bien para una persona y se desmoronan ante un modelo de imagen, porque la identidad, el mundo y el estilo visual están dispersos en tres frases distintas en lugar de estar en una que pueda interpretar. Describe quiénes son, genera una versión estructurada y pruébala con un render real directamente en el mismo lienzo. Los créditos gratuitos cubren la primera ronda.
Seedance 2.0 de ByteDance produce imagen y sonido en una sola pasada, a partir de un primer y último fotograma o de imágenes de referencia, en tamaños que van de 480P a 4K nativo.
Veo 3.1 de Google DeepMind genera clips cortos con audio sincronizado de 48kHz y los amplía en secuencias más largas llevando los fotogramas finales hacia delante.
Kling 3.0 de Kuaishou habla: diálogo sincronizado con los labios en cinco idiomas, una voz distinta por personaje y un modo storyboard que estructura una secuencia completa.
Una imagen, una frase y un clip que puedes ver antes de terminar de decidir si merecía la pena probarlo.