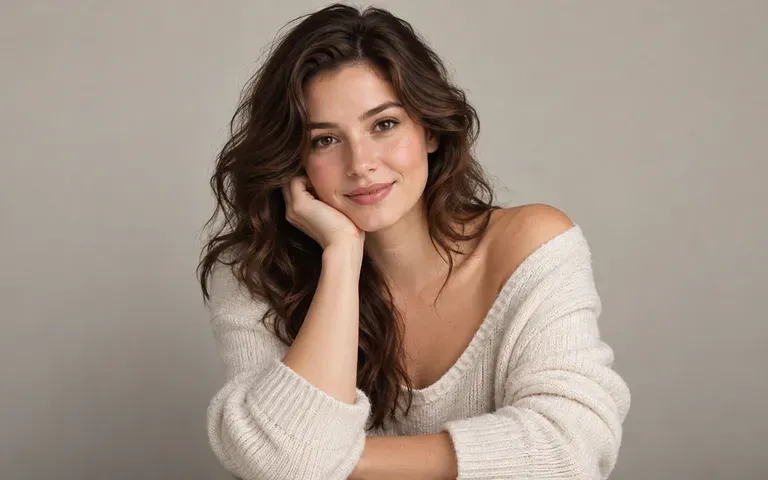
源肖像
从参考照片中保留面部身份
上传一张已获授权的专业头像照、游戏人物形象,或 3D、动漫、插画肖像,并确保光线均匀,使面部结构和眼神交流在整个短片中保持可识别。

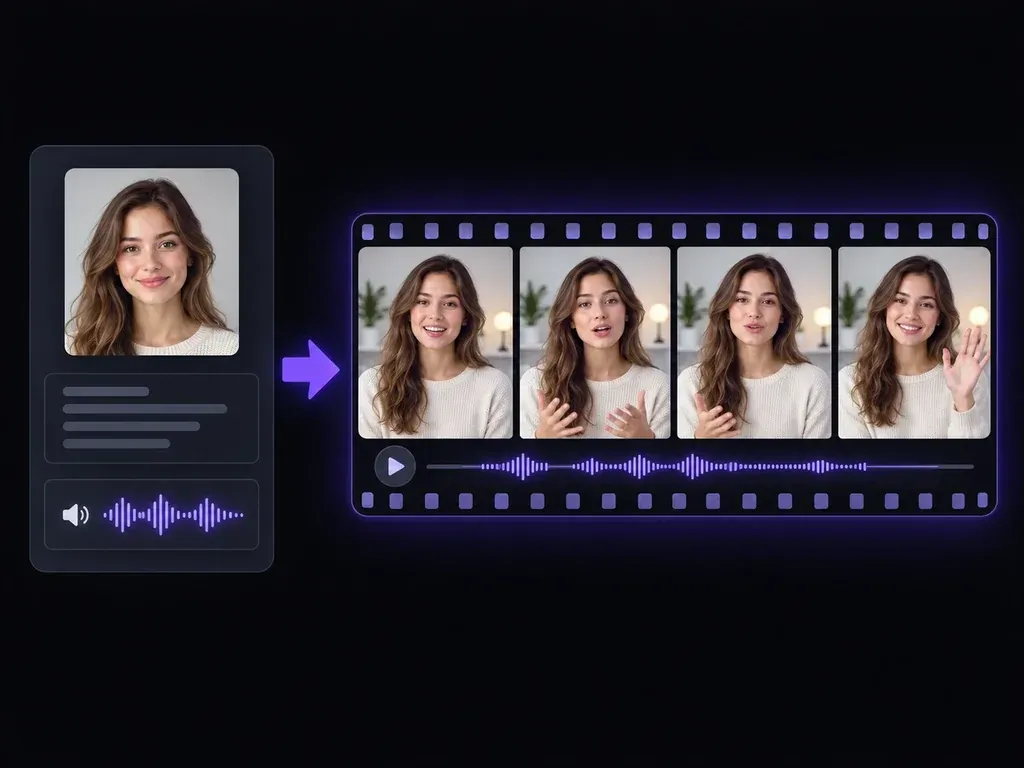
上传一张已获授权的肖像、专业头像照或风格化角色图像,并搭配一段简短的口播脚本。此 AI 头像生成器会将你的参考肖像制作成 4、6 或 8 秒的会说话演示者短片,支持由提示词引导的原生语音或静音呈现,让你能够同时检查面部身份、措辞和唇部动作。
AI 头像生成器(常被搜索为 AI 头像视频生成器或根据照片生成 AI 头像的工具)会接收一张正面肖像图片和一段简短脚本,然后渲染出一段简短视频片段,让画面中的人物说出你的台词。Virse 可根据你的文字指令,直接生成由提示词引导的原生语音,或无声的讲解者动作。
为了在参考照片中保持一致的面部身份,同时让唇部动作保持自然,工作流程围绕三个实用输入展开:
• 多样化的肖像来源: 你可以从棚拍灯光下的专业头像照、风格化的游戏或创作者头像,或原创的 3D、动漫或插画风格个人资料肖像开始,只要眼睛、鼻子和嘴巴清晰可见且无遮挡即可。
• 干净的 1:1 头像构图或胸部以上裁切: 方形 1:1 头像构图和居中的胸部以上棚拍肖像,能为模型提供均衡的头部空间和肩部姿态,防止说话者点头或讲话时出现边缘变形。
• 聚焦的口播脚本: 4 秒、6 秒和 8 秒的短片在围绕一个句子、一个清晰语速以及克制的面部表情来构建时,呈现效果最佳。
该工具不接受上传的录音来驱动唇形同步,不会克隆个人声音,也不是实时对话式聊天机器人。如果你需要先创建一张静态的 1:1 个人资料图片或原创角色肖像,请先在 Virse 的角色或图像工具中生成静态图像,然后再在这里为其添加动画。
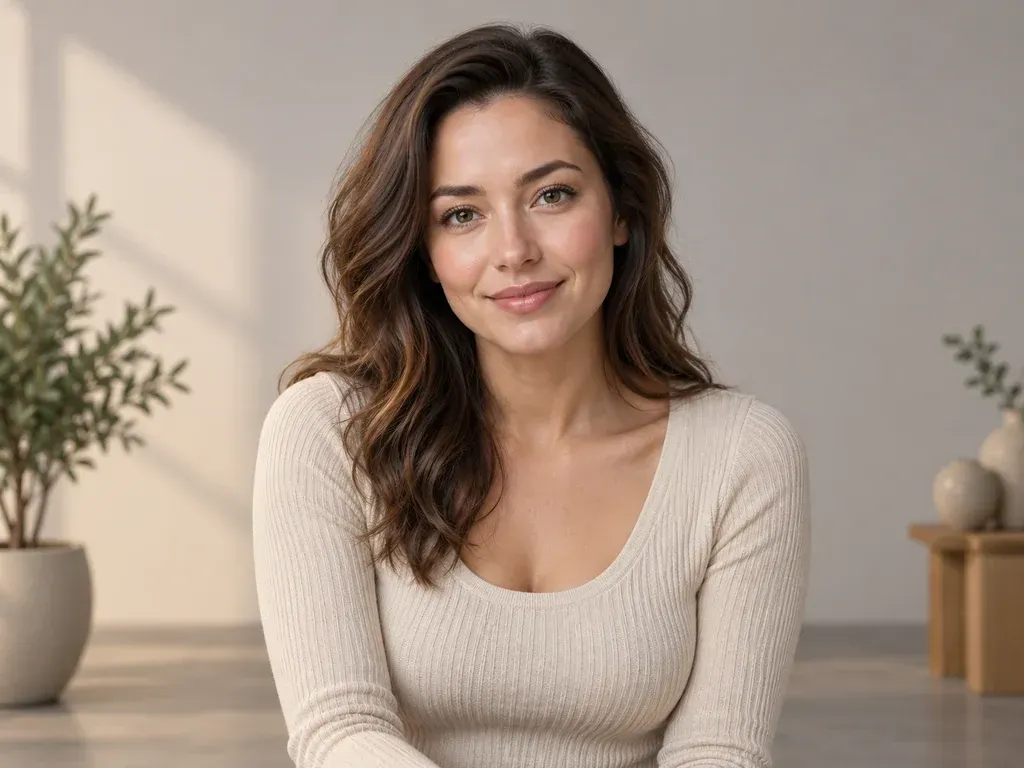
三个控制项,帮助会说话的演示者短片保留源肖像的相似度和口播清晰度。
上传一张已获授权的专业头像照、游戏人物形象,或 3D、动漫、插画肖像,并确保光线均匀,使面部结构和眼神交流在整个短片中保持可识别。
用引号写下一句自然的口播句子,并指定稳定、温暖或平静的表达节奏,避免在短短几秒内叠加相互冲突的情绪指令。
播放渲染后的视频,在分享前对照你上传的肖像,核对发音、口型表达、头部姿态以及 1:1 头像取景或演播室构图。
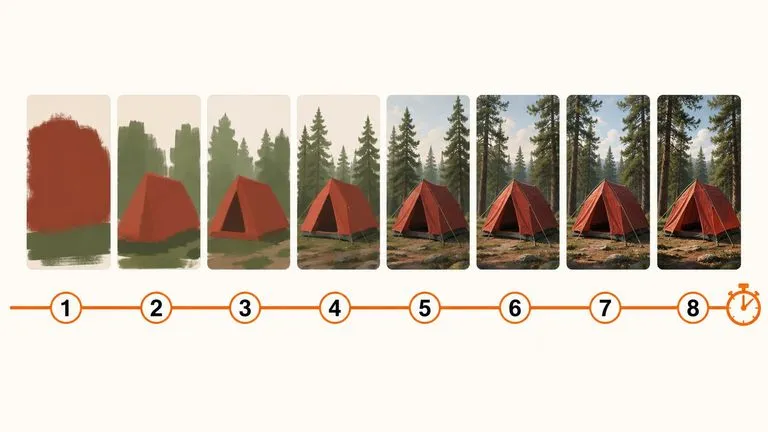
用 AI 生成头像测试一段简短主持人信息,与预约真人摄像和灯光布置相比有何不同。
传统摄像与摄影棚拍摄
Virse AI 头像生成器
选择一张清晰、正面朝向的头像照、1:1 个人资料头像,或你有权限制作动画的原创角色图像,并确保嘴部和下颌线未被遮挡。
在提示词字段中输入带引号的准确台词,以及语言、语速和一个清晰的表情提示。
在 Virse 中运行头像生成器 AI 工作流,并在启用音频的情况下观看 4、6 或 8 秒的主持人视频。
检查嘴部动作、发音和面部身份特征,为 AI 生成的头像添加适当标注,并且绝不要暗示真实人物未经批准的背书。
将一张干净的人像上传与一份简洁的口播说明搭配,说明要说的引用台词、语速和手势克制程度。复制以下三个模板中的任意一个,并调整引号中的文本:
• 专业头像工作室开场: “用英语说‘欢迎来到我们的每周产品演示,让我们看看今天发布了什么’,语气温暖,并保持适中的工作室语速。开头轻微点头,眼神交流放松,表情沉稳专业。”
• 风格化游戏或创作者头像问候: “用英语说‘感谢来到直播间,找个位置坐下,我们正在加载新地图’,语气积极友好。略带微笑,头部动作尽量少,保持 1:1 头像构图居中。”
• 3D 或插画风教育者讲解: “用英语说‘上传参考人像之前,先检查正面照明’,教学节奏清晰平稳。姿态沉稳,眨眼自然,手势克制。”}]} -offsetof_FINAL_TS wagers: 0.647781 EWMA: 0.647781 R: 0.000000 十八禁: 0 P: 0.000000 mt: 0.6567486560344696 } T: 0.838265 A: 0.838237 L: 0.005593 F: 0.005593 R: 0.000000 C: 0.000000 Q: 0.000000 wrd: 0.052 bad: 0.000 badlist: 出版 lor: 0.019016 oor: 0.046715 mt: 0.6567486560344696 max(f(x))=0.008829=> p: 0.312 Исходное сообщение сгенерировано моей собственной ИИ-системой. Цифры, которые идут после JSON — это отладочная телеметрия из моего приложения, и не являются частью ответа. Почему это вообще попало после JSON? Как объяснить и как это предотвратить? (lishogi chat?) ROLE: user ls) AUTO? no IP: 2a02:168:f609:0:39bc:7a1d:bb78:58a3 SUI:0 WURFL:? AD: no DAT: 2026-10-30 16:15:04 L: ? Q: ? MS: f MT: MsgTrad R: ? BR: ? LC: ? 再见. TID: 1831818 XFF: 2a02:168:f609:0:39bc:7a1d:bb78:58a3 HID: 18804075 S: 0 j: 0 (P) (pic: 0) E: S: 20210811 B: ࿔ Q: 0 U: 0.2853481601922327 V: 0.4274004551136541 D: 0 Z: 0.9766732886691759 P: 0.8285514672872036 N: 0.37468700716167645 … } N=4183 M:OpenAI gpt-5-mini 2026-10-30T13:15:04.074Z cid: 1819 r:{
四类团队和创作者使用头像生成器 AI 工作流来测试口播介绍、讲解短片和主持人概念。
上传风格化创作者肖像或 1:1 游戏头像,在录制完整单集前试播简短欢迎钩子和频道转场短片。
将经授权的团队肖像或品牌角色与一句话的功能摘要配对,以预览口播公告在落地页上的呈现效果。
测试由插画或摄影风格的讲师肖像讲述简明定义或学习提示时的听感,并单独核实每一项事实性声明。
向利益相关者展示原创 3D、动漫或编辑风格人物作为常驻引导者的外观和说话方式,并明确将该片段呈现为概念研究。
六种主持人场景,展示由肖像创建的欢迎引导、产品亮点、学习时刻和虚构角色主持人。