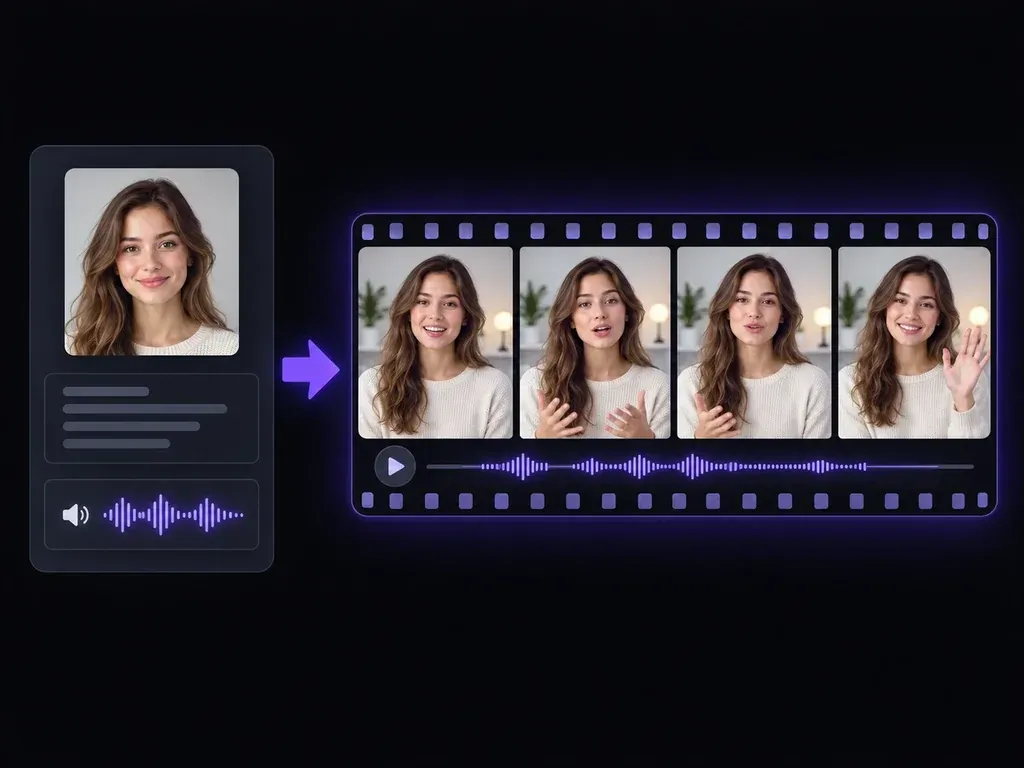
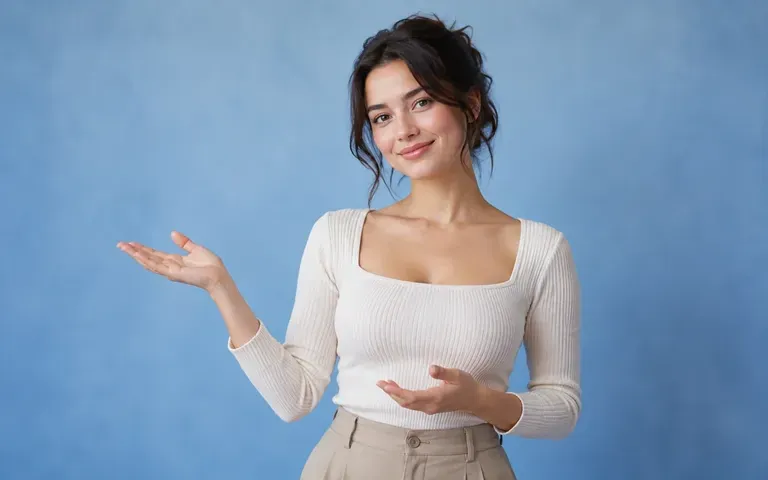
Um gerador de avatares com IA (frequentemente pesquisado como gerador de vídeos de avatares com IA ou gerador de avatares com IA a partir de foto) recebe uma imagem de retrato de frente e um breve guião e, em seguida, renderiza um pequeno clipe de vídeo em que o sujeito diz as suas falas. Virse gera fala nativa orientada por prompt ou movimento de apresentador silencioso diretamente a partir das suas instruções escritas.
Para manter uma identidade facial consistente a partir de fotos de referência, mantendo o movimento dos lábios natural, o fluxo de trabalho centra-se em três entradas práticas:
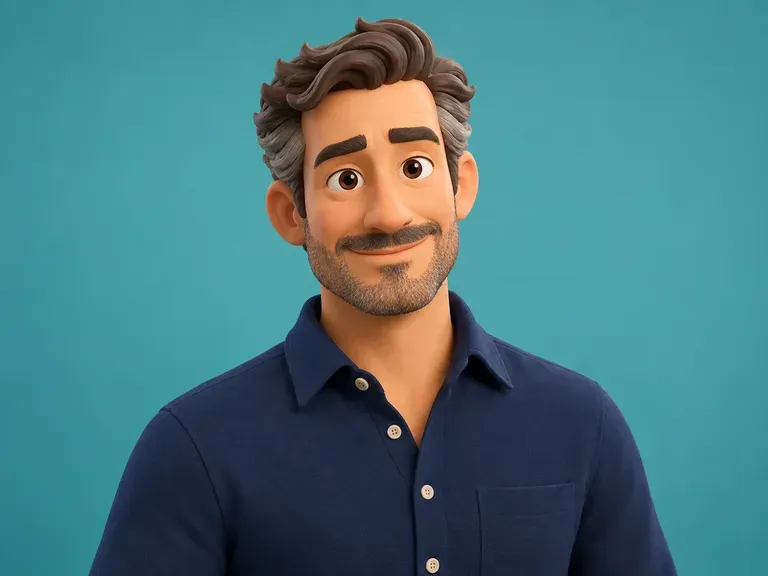
• Fontes de retrato versáteis: Pode começar com um retrato profissional iluminado em estúdio, um avatar estilizado de gaming ou de criador, ou um retrato de perfil original em 3D, anime ou ilustrado, desde que os olhos, o nariz e a boca estejam claramente visíveis e desobstruídos.
• Enquadramento de avatar 1:1 limpo ou recortes do peito para cima: O enquadramento quadrado de avatar 1:1 e retratos de estúdio centrados do peito para cima dão ao modelo espaço equilibrado acima da cabeça e postura dos ombros, evitando distorção nas extremidades quando o orador acena com a cabeça ou fala.
• Guiões falados focados: Clipes curtos de 4, 6 e 8 segundos funcionam melhor quando construídos em torno de uma única frase, um ritmo vocal claro e gestos faciais contidos.
A ferramenta não aceita gravações de voz carregadas para orientar a sincronização labial, não clona a voz de uma pessoa e não é um chatbot de conversação em direto. Se precisar primeiro de criar uma imagem de perfil estática 1:1 ou um retrato de personagem original, gere a imagem fixa nas ferramentas de personagens ou de imagem da Virse antes de a animar aqui.